Edición diaria
TheVortiq
El diario de la inteligencia artificial, la automatización y el software
Empresas
GTA VI edición física: sin disco, solo un código
La versión física del esperado juego de Rockstar incluirá un código de descarga en lugar del disco, una tendencia que ya no sorprende
TheVortiq
¿Qué ha ocurrido?
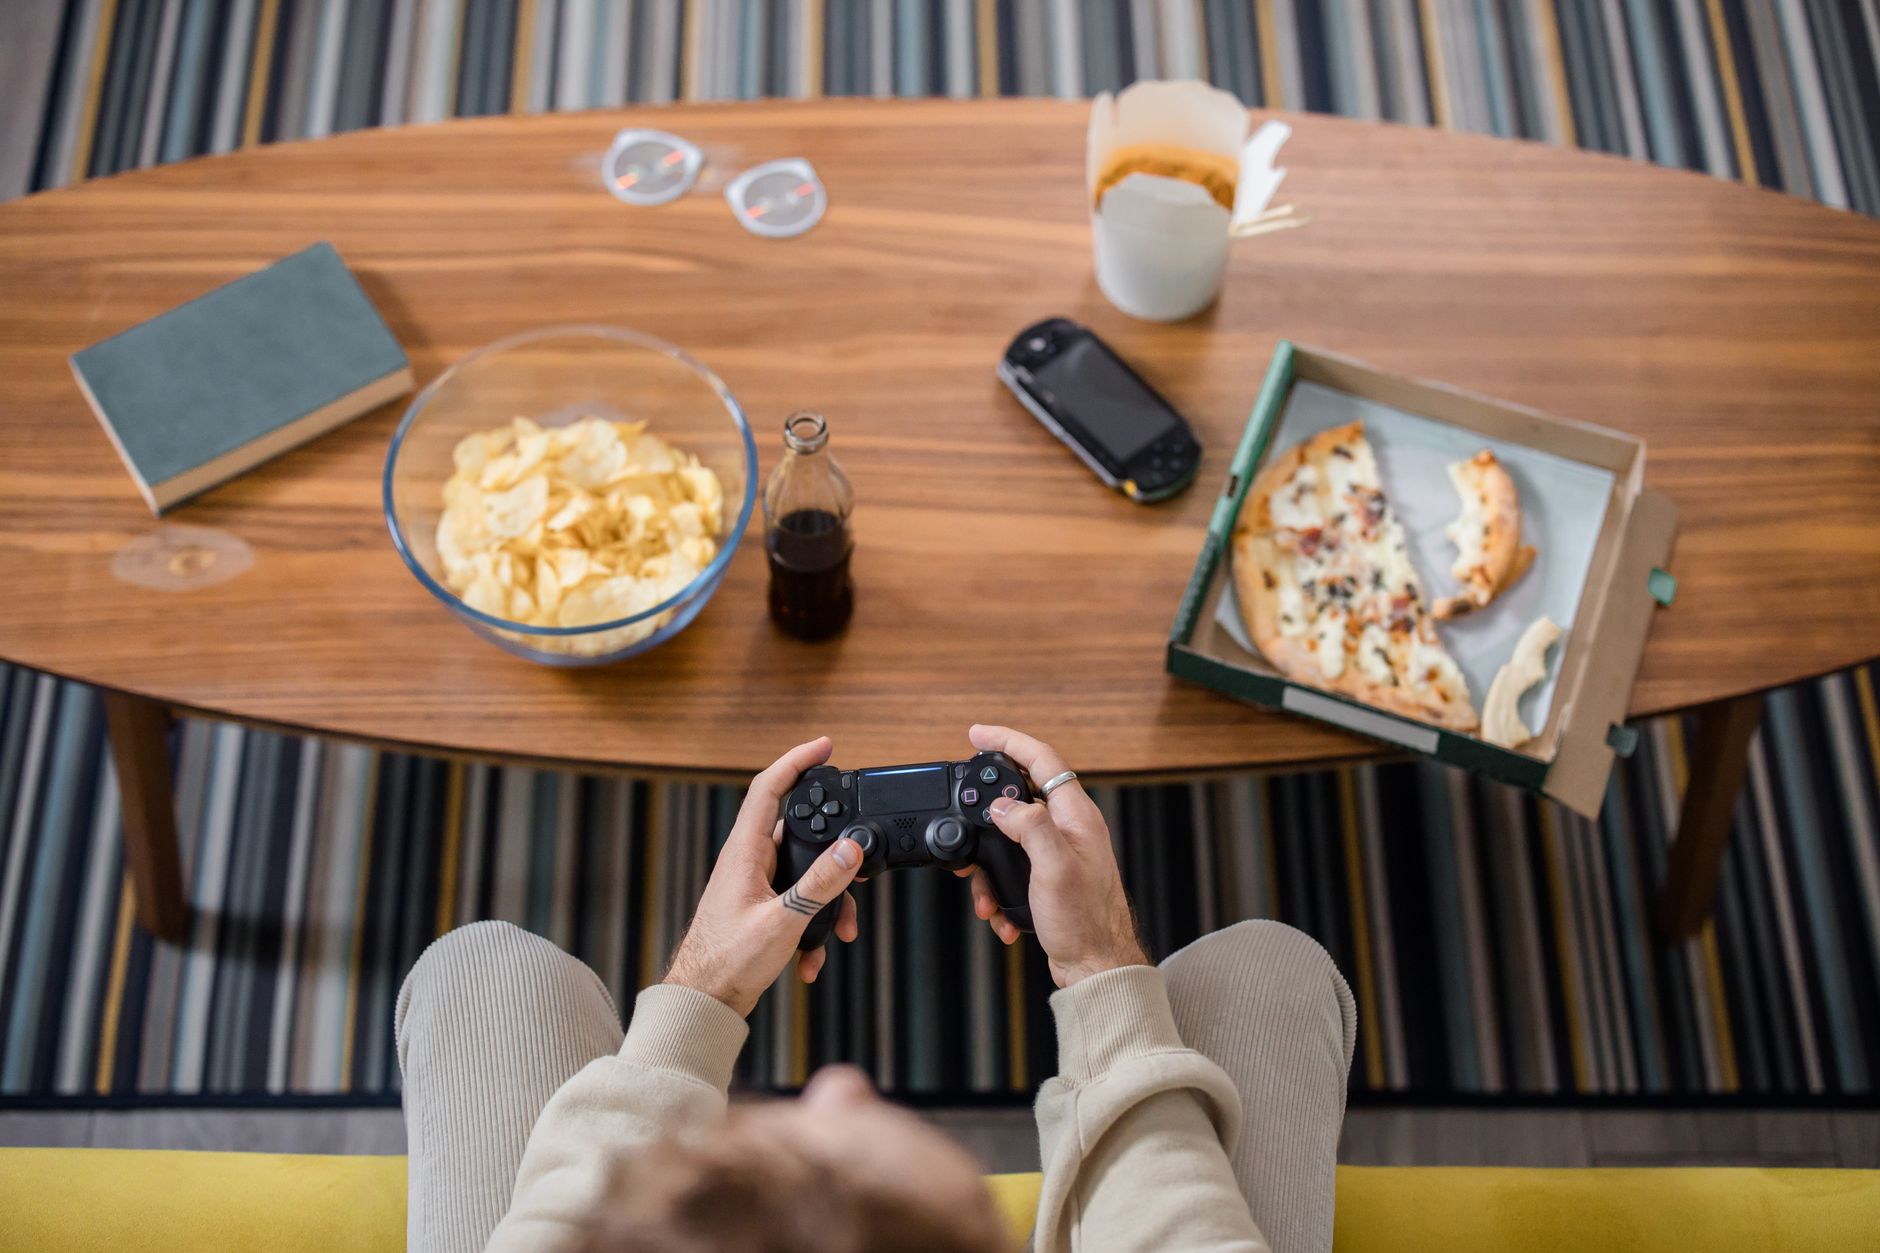
Rockstar Games ha confirmado que la edición física de 'GTA VI', cuyo lanzamiento está previsto para el 19 de noviembre de 2025, no contendrá un disco. En su lugar, la caja incluirá un código de descarga que permite acceder al juego digitalmente. Esta información, adelantada por Xataka, refleja una tendencia creciente en la industria: el formato físico se convierte en un mero contenedor de un código digital. La noticia, aunque esperada, marca un hito al tratarse de uno de los lanzamientos más anticipados de la década, con un presupuesto estimado de más de 2.000 millones de dólares y una comunidad de seguidores que abarca décadas.
¿Por qué es importante?
La decisión de Rockstar, uno de los estudios más influyentes, consolida un cambio de paradigma que afecta directamente la propiedad del juego, el mercado de segunda mano y la preservación histórica. Como señala Xataka, cada vez más videojuegos físicos son 'pisapapeles', citando el caso de 'Star Wars Jedi: Survivor'. Pero el impacto va más allá: según un informe de la Entertainment Software Association (ESA), las ventas digitales representaron el 89% del mercado total de videojuegos en 2024, frente al 74% en 2020. Esta aceleración se debe en parte a que títulos como 'Alan Wake 2' (2023) y 'Star Wars Jedi: Survivor' (2023) ya optaron por códigos en sus ediciones físicas. Sin embargo, que 'GTA VI', un juego que se espera venda más de 25 millones de copias en su primer año, adopte este modelo, lo normaliza y acelera su aceptación entre el público masivo.
Consecuencias para la industria
- Para los jugadores: La imposibilidad de revender o prestar el juego, ya que el código está vinculado a una cuenta de PlayStation Network o Xbox Live. Además, si los servidores de Rockstar cierran en el futuro, el juego podría perderse, un riesgo que ya se ha materializado en títulos como 'The Crew' (Ubisoft, 2024), cuyos servidores fueron apagados, dejando el juego injugable incluso en formato físico. Según la organización de preservación Video Game History Foundation, el 87% de los videojuegos lanzados antes de 2010 ya no están disponibles comercialmente.
- Para coleccionistas: La caja pierde valor como objeto físico auténtico, convirtiéndose en un empaque vacío. En el mercado de segunda mano, ediciones especiales de juegos como 'The Legend of Zelda: Breath of the Wild' se venden por hasta 300 dólares, mientras que un código usado no tiene valor de reventa.
- Para el mercado: Se acelera la migración hacia lo digital, reduciendo costos de producción y distribución (un disco Blu-ray cuesta aproximadamente 1,50 dólares frente a 0,10 dólares de un código impreso), pero limitando los derechos del consumidor. Empresas como GameStop han visto caer sus ingresos un 20% anual desde 2020, y la desaparición del disco físico podría acelerar su declive.
Contexto histórico
Inteligencia Artificial
IBM fabrica el primer chip subnanométrico del mundo: 0,7 nm
La compañía presenta un chip de 0,7 nm con tecnología de nanoláminas apiladas que promete hasta un 50% más de rendimiento o un 70% más de eficiencia energética frente a los de 2 nm.
TheVortiq

¿Qué ha ocurrido?
IBM ha anunciado la fabricación del primer chip del mundo con tecnología de proceso subnanométrica, concretamente en un nodo de 0,7 nm (7 ángstroms). Este logro, reportado por Xataka, representa un hito histórico porque cruza la barrera del nanómetro en la fabricación de semiconductores, algo que la industria perseguía desde hace años. El chip integra casi 100.000 millones de transistores en un área del tamaño de una uña, gracias a una innovadora arquitectura tridimensional denominada nanostack (nanoapilamiento). Para contextualizar, el primer microprocesador comercial, el Intel 4004 de 1971, tenía solo 2.300 transistores en un área de aproximadamente 12 mm². Hoy, IBM empaqueta 43 millones de veces más transistores en un espacio comparable. Este salto no es solo cuantitativo: la densidad de transistores alcanza niveles que permiten integrar sistemas completos en un solo chip, reduciendo latencias y consumo energético. El logro de IBM es especialmente relevante porque la industria llevaba años estancada en la transición de los 7 nm a los 5 nm, y luego a los 3 nm, con TSMC y Samsung liderando. La barrera del nanómetro parecía infranqueable debido a los efectos cuánticos que aparecen por debajo de los 10 nm, como el túnel de electrones o la variabilidad en el voltaje umbral. IBM ha superado estos desafíos mediante un enfoque radicalmente distinto: en lugar de reducir simplemente las dimensiones de los transistores planares tradicionales, ha apilado nanoláminas de silicio en 3D, creando una estructura vertical que mejora el control de la corriente y reduce las fugas. Este método, conocido como Gate-All-Around (GAA) con nanosheets, ya había sido explorado por otros fabricantes para nodos de 3 nm y 2 nm, pero IBM lo ha llevado al extremo subnanométrico. La compañía ha confirmado que el chip es funcional y ha pasado pruebas preliminares, aunque sigue siendo un prototipo de laboratorio sin fecha de producción en masa. No obstante, el anuncio ha provocado reacciones en toda la industria: TSMC, que planea lanzar su nodo de 2 nm en 2025, y Samsung, con su proceso de 3 nm GAA ya en producción, ahora enfrentan la presión de acelerar sus hojas de ruta.
¿Por qué es importante?
Superar la barrera del nanómetro no es solo una cuestión de escala. Durante décadas, la Ley de Moore ha guiado la miniaturización de transistores, pero a medida que nos acercamos a las dimensiones atómicas, la física cuántica impone desafíos enormes. IBM ha logrado este avance no mediante una simple reducción de los diseños convencionales, sino reinventando la estructura del transistor con nanoláminas apiladas en 3D, lo que mejora el rendimiento eléctrico en un espacio más reducido. La Ley de Moore, que postula que el número de transistores en un chip se duplica aproximadamente cada dos años, se ha ido ralentizando desde principios de la década de 2010, cuando los nodos de 28 nm y 22 nm empezaron a mostrar rendimientos decrecientes. El paso a los 14 nm, 10 nm y 7 nm requirió inversiones multimillonarias en litografía ultravioleta extrema (EUV) y nuevos materiales como el hafnio para dieléctricos de alta k. Sin embargo, por debajo de 5 nm, los efectos cuánticos hacen que los transistores tradicionales de tipo FinFET pierdan eficiencia. IBM, con su arquitectura de nanosheets apilados, ofrece una solución viable que podría extender la Ley de Moore por al menos otra década. Según IBM, este nuevo chip ofrece hasta un 50% más de rendimiento o un 70% más de eficiencia energética en comparación con sus propios chips de 2 nm. Esta flexibilidad permite a los diseñadores ajustar el chip según la aplicación: desde inteligencia artificial generativa hasta infraestructura en la nube o dispositivos de próxima generación. Por ejemplo, un centro de datos que opere con 10.000 procesadores de 0,7 nm podría reducir su consumo energético en un 70%, lo que supondría un ahorro de millones de dólares en electricidad y una disminución significativa de la huella de carbono. En el ámbito de la IA, los modelos de lenguaje como GPT-4 requieren enormes cantidades de memoria y cómputo; un chip con 100.000 millones de transistores podría integrar memoria y lógica en el mismo sustrato, reduciendo la latencia de acceso a datos y acelerando el entrenamiento. Además, la eficiencia energética mejorada permitiría que los dispositivos móviles ejecuten inferencias de IA localmente sin depender de la nube, mejorando la privacidad y la capacidad de respuesta. El impacto en la supercomputación también sería notable: máquinas como Frontier, que actualmente consume 21 MW, podrían alcanzar rendimientos exaescala con un tercio de la potencia.
Consecuencias para la industria
Inteligencia Artificial
Superhuman compra GPTZero: el detector de IA que contradice su negocio
La empresa de escritura asistida por IA adquiere la startup que detecta texto generado por máquinas, en un movimiento estratégico lleno de paradojas.
TheVortiq
¿Qué ha ocurrido?
Superhuman, la compañía conocida por su asistente de escritura basado en IA (antes Grammarly), ha adquirido GPTZero, la startup fundada por Edward Tian que detecta si un texto ha sido generado por inteligencia artificial. Según The Next Web, la operación ronda los 30 millones de dólares. GPTZero, lanzada en 2023, se hizo viral por ayudar a educadores a identificar trabajos escritos con ChatGPT. La adquisición cierra un capítulo para la startup, que había recaudado 3,5 millones en una ronda semilla liderada por Floodgate Fund. Superhuman, por su parte, fue adquirida en 2023 por una firma de capital privado y ha estado expandiendo su suite de productividad. La compra de GPTZero marca su entrada en el mercado de verificación de autenticidad, un movimiento que refleja la creciente necesidad de confianza en un ecosistema digital inundado de contenido generado por máquinas.
Una paradoja estratégica
La ironía es evidente: Superhuman ayuda a escribir mejor con IA, mientras GPTZero detecta ese mismo tipo de escritura. Pero la contradicción es deliberada. Superhuman busca posicionarse como el estándar de confianza en un ecosistema donde distinguir entre texto humano y generado por máquinas se ha vuelto crucial. La adquisición permite a Superhuman ofrecer una capa de verificación de autenticidad, que podría integrarse en su producto principal o venderse como servicio independiente. Según The Next Web, el CEO de Superhuman, Shishir Mehrotra, declaró que la combinación de herramientas de escritura y detección crea un 'círculo virtuoso' para la transparencia. Esta paradoja no es única: en 2023, OpenAI lanzó su propio detector de IA, solo para retirarlo meses después por su baja precisión. GPTZero, en cambio, ha mantenido una tasa de precisión reportada del 99% en textos académicos, aunque con falsos positivos en textos creativos. La estrategia de Superhuman es similar a la de empresas como Microsoft, que integra herramientas de IA y de verificación en su suite Office, pero con un enfoque más especializado.
Impacto en el mercado
La compra refleja una tendencia creciente: la necesidad de herramientas que certifiquen la autoría humana. Con la proliferación de contenido generado por IA, desde artículos hasta reseñas de productos, la confianza se ha convertido en un activo escaso. Empresas como OpenAI han experimentado con marcas de agua, pero ninguna solución ha sido perfecta. GPTZero, aunque no infalible, ofrece un enfoque práctico basado en patrones de perplejidad y burstiness. El mercado de detección de IA se estima en 1.500 millones de dólares para 2027, según un informe de MarketsandMarkets citado por TechCrunch. Competidores como Originality.ai (valorada en 50 millones) y Turnitin (con su detector integrado en plataformas educativas) ya están posicionados. La adquisición de GPTZero por 30 millones valida el segmento y podría desencadenar una consolidación similar a la vista en 2023 con la compra de Jasper AI por parte de Writer. Para los usuarios, esto significa que la detección de IA pasará de ser una herramienta independiente a un componente integrado en suites de productividad, lo que podría estandarizar las prácticas de verificación.
Consecuencias para usuarios y competidores
Para los educadores, que fueron los primeros usuarios de GPTZero, la adquisición podría significar cambios en la disponibilidad gratuita de la herramienta. Actualmente, GPTZero ofrece un plan gratuito limitado y planes de pago para instituciones. Superhuman podría integrar la detección en su suite empresarial, dejando fuera a usuarios individuales o elevando los precios. Competidores como Originality.ai o Turnitin (con su detector de IA) tendrán que diferenciarse aún más, quizás mediante integraciones más profundas o modelos de negocio más flexibles. Además, la operación valida el mercado de la detección de IA, que algunos consideraban una moda pasajera. Sin embargo, la precisión sigue siendo un desafío: un estudio de la Universidad de Maryland de 2024 encontró que los detectores de IA tienen una tasa de falsos positivos del 5% en textos nativos en inglés, que aumenta al 15% en textos de hablantes no nativos. Esto podría generar problemas de sesgo si la herramienta se usa en reclutamiento o evaluación académica. Superhuman tendrá que abordar estas limitaciones para mantener la confianza.
Lo que los lectores deben saber
- La adquisición no está exenta de escepticismo: los detectores de IA tienen tasas de falsos positivos y pueden ser engañados con técnicas simples como parafraseo o uso de modelos adversariales.
- Superhuman podría usar GPTZero para mejorar su propio modelo, entrenándolo con datos etiquetados como humanos vs. IA. Esto podría mejorar tanto la escritura asistida como la detección, creando un ciclo de retroalimentación.
- El precio de 30 millones es modesto comparado con otras adquisiciones en IA, como la compra de DeepMind por Google (500 millones) o la de OpenAI por Microsoft (13.000 millones), pero refleja el valor de una herramienta con fuerte reconocimiento de marca y una base de usuarios leales en el ámbito educativo.
- La integración podría extenderse a otros productos de Superhuman, como su asistente de correo electrónico o su herramienta de escritura colaborativa, ofreciendo verificación en tiempo real.
Contexto histórico
Desde el lanzamiento de ChatGPT en 2022, la detección de IA ha sido un campo en ebullición. GPTZero surgió como respuesta a la demanda de profesores, pero pronto encontró aplicaciones en periodismo, reclutamiento y verificación de contenido. La compra por parte de Superhuman, que a su vez fue adquirida por una firma de capital privado en 2023, muestra cómo las empresas de productividad buscan consolidar su oferta en un mercado fragmentado. En 2024, vimos movimientos similares: la adquisición de Replika por parte de una empresa de bienestar digital, y la compra de Copy.ai por una firma de automatización de marketing. La tendencia es clara: las herramientas de IA generativa y las de detección se están fusionando para ofrecer soluciones integrales. Históricamente, la detección de contenido generado por máquinas ha sido un campo de batalla desde los primeros chatbots, pero la escala actual no tiene precedentes.
«La ironía es el punto: demostrar que algo es humano se ha convertido en un producto», señaló un analista citado por The Next Web. Esta frase resume la paradoja central de la adquisición, que no es única en la industria: en 2023, la empresa Originality.ai lanzó una herramienta de escritura con IA junto a su detector, buscando el mismo equilibrio.
Especulaciones y futuro
Software
Navegadores y Cloudflare crean PACT para autenticar tráfico humano y combatir bots
El nuevo protocolo PACT busca verificar accesos legítimos sin CAPTCHAs ni seguimiento invasivo, con el respaldo de Chrome, Firefox y Edge.
TheVortiq

¿Qué ha ocurrido?
Cloudflare ha anunciado una iniciativa conjunta con los principales navegadores —Google Chrome, Mozilla Firefox y Microsoft Edge— para desarrollar un nuevo protocolo de internet llamado Private Access Control Tokens (PACT). El objetivo es verificar si el acceso a un sitio web es legítimo (humano o agente autorizado) o malicioso, sin recurrir a CAPTCHAs ni sistemas de seguimiento invasivos. La noticia fue publicada por TechRadar y confirmada por el propio comunicado de Cloudflare.
Según datos de Cloudflare Radar, el tráfico de bots ha superado oficialmente las solicitudes HTTP humanas en la web, lo que ha motivado la búsqueda de soluciones más eficaces y respetuosas con la privacidad. Los navegadores participantes suman aproximadamente el 77% del mercado según StatCounter, lo que asegura una adopción masiva del protocolo.
¿Por qué es importante?
El equilibrio entre seguridad y experiencia de usuario es un desafío constante. Los CAPTCHAs y otros métodos de verificación generan fricción, afectan las tasas de conversión y pueden ser vulnerables a ataques avanzados. PACT propone un enfoque basado en tokens anónimos de “personhood” (personalidad) que se generan en el navegador del usuario a partir de contextos de confianza, como la interacción previa con servicios autenticados, pero sin revelar información personal.
Además, el protocolo está diseñado para reconocer también tráfico legítimo de bots, como los agentes de IA autorizados, lo que resulta crucial en un momento en que la automatización crece exponencialmente. Como señaló Ilya Grigorik, ingeniero distinguido de Shopify, en el comunicado de Cloudflare: “En el comercio, cada desafío adicional, retraso o falso positivo puede convertir una compra en un carrito abandonado. Los comerciantes necesitan protecciones efectivas contra el abuso automatizado, pero los compradores no deberían pagar por ellas con fricción innecesaria o seguimiento invasivo”.
¿Cómo funciona PACT?
PACT se basa en tokens de control de acceso privados. El navegador del usuario emite un token anónimo que acredita que el acceso proviene de una entidad con una relación auténtica con un servicio (por ejemplo, haber iniciado sesión previamente o usar un dispositivo verificado). Este token se presenta al sitio web sin revelar la identidad del usuario ni datos de navegación. Cloudflare actuará como uno de los emisores de confianza, pero el protocolo es abierto y cualquier entidad podría implementarlo.
Según Cloudflare, el protocolo “eleva el estándar de confianza e integridad en línea sin los costos tradicionales”. No se requiere inicio de sesión adicional ni interacción del usuario; el token se genera de forma transparente en segundo plano.
Consecuencias y perspectivas
Si PACT se implementa con éxito, podría reducir drásticamente el uso de CAPTCHAs y otros métodos de verificación molestos, mejorando la experiencia de navegación y las tasas de conversión en sitios de comercio electrónico. También podría dificultar la acción de bots maliciosos, ya que los tokens requieren una “prueba de humanidad” indirecta que no es fácil de falsificar a gran escala.
Sin embargo, quedan interrogantes sobre la adopción por parte de otros navegadores y la posible centralización del sistema si solo unos pocos emisores controlan la emisión de tokens. La privacidad es un punto fuerte, pero será crucial auditar el código abierto del protocolo para garantizar que no se generan vectores de seguimiento encubiertos.
Para los lectores, la principal recomendación es mantenerse informados sobre la evolución de PACT, ya que podría cambiar la forma en que interactuamos con la web. Las empresas, especialmente las de comercio electrónico y servicios online, deberían prepararse para integrar este protocolo si buscan reducir la fricción en la autenticación de usuarios legítimos.
“PACT representa un paso adelante hacia una web más segura y menos intrusiva, donde la verificación de humanidad no comprometa la privacidad ni la experiencia del usuario.”
Inteligencia Artificial
Apple sube precios de Mac y iPad por el alto costo de chips de memoria impulsado por la IA
La demanda de memoria HBM para entrenar modelos de inteligencia artificial está encareciendo los componentes de consumo, y Apple traslada el costo a los usuarios.
TheVortiq

¿Qué ha ocurrido?
Apple ha anunciado una subida de precios en toda su línea de Mac y iPad, atribuyéndola al incremento del costo de los chips de memoria y almacenamiento. La compañía culpa directamente al auge de la inteligencia artificial, que ha disparado la demanda de memoria de alto ancho de banda (HBM) utilizada en centros de datos, reduciendo la oferta disponible para electrónica de consumo y elevando los precios. Según The Next Web, los incrementos oscilan entre un 5% y un 10% según el modelo, y afectan tanto a configuraciones base como a personalizadas. Este movimiento no es aislado: Samsung y SK Hynix, los principales fabricantes de memoria, han reportado aumentos de precios de hasta un 20% en DRAM y NAND en el último trimestre, impulsados por la demanda de servidores de IA. Apple, al ser uno de los mayores compradores de estos componentes, traslada ahora ese sobrecosto al consumidor final.
¿Por qué es importante?
Este movimiento demuestra que la escasez de chips inducida por la IA ya no es solo un problema de servidores, sino que afecta a productos cotidianos. A diferencia de crisis anteriores (como la pandemia), ahora el desequilibrio se debe a la competencia por componentes específicos, como la memoria DRAM y NAND, entre el sector de consumo y el de infraestructura de IA. Durante la pandemia, la escasez fue generalizada por disrupciones logísticas; hoy, es selectiva y estructural. La demanda de HBM3 y HBM3E, utilizada en aceleradores como el NVIDIA H100, ha crecido un 300% interanual, según datos de mercado. Esto ha desviado la capacidad de producción de memorias convencionales, encareciendo los chips que usan los Mac y iPad. Además, Apple no es la única: otros fabricantes de PC como Dell y Lenovo han empezado a ajustar precios, aunque de forma menos visible. La decisión de Apple, por su visibilidad, marca un punto de inflexión en la percepción pública del impacto de la IA en la economía real.
Consecuencias para empresas y usuarios
Para los consumidores, la subida supone un encarecimiento de dispositivos ya de por sí costosos. Un MacBook Pro base, que antes costaba 1.999 euros, ahora podría rondar los 2.199 euros en su configuración mínima. Las empresas que dependen de Mac o iPad para su trabajo verán incrementados sus costos de renovación de equipos, lo que podría retrasar ciclos de actualización o forzar a buscar alternativas como el alquiler de hardware. A largo plazo, podría acelerar la adopción de suscripciones o alquiler de hardware, así como impulsar el mercado de segunda mano. Según analistas de IDC, el mercado de PC usados creció un 12% en el último año, tendencia que podría reforzarse. Además, las empresas con flotas de dispositivos Apple podrían verse obligadas a extender la vida útil de sus equipos, lo que afecta a la productividad y a la seguridad (al no contar con las últimas actualizaciones de hardware). En el ámbito educativo, donde el iPad es una herramienta común, los presupuestos ajustados podrían reducir la penetración de Apple en ese segmento.
¿Qué deben saber los lectores?
- Los aumentos varían según el modelo, pero rondan entre un 5% y un 10%. Por ejemplo, el iPad Pro sube unos 50 euros en su versión base, mientras que el Mac Studio puede incrementarse hasta 200 euros en configuraciones altas.
- No se espera que esta tendencia se revierta a corto plazo, ya que la demanda de IA sigue creciendo. Los fabricantes de memoria han anunciado que priorizarán la producción de HBM durante al menos los próximos 12 meses.
- Alternativas: considerar equipos con configuraciones de memoria base, o esperar a posibles promociones de Black Friday o back-to-school. También se puede optar por modelos refurbished de Apple, que suelen tener descuentos del 15% al 20%.
- Para empresas, evaluar programas de leasing o suscripción como Apple Business, que distribuyen el costo en el tiempo y permiten actualizaciones más flexibles.
Este episodio subraya la interconexión entre la tecnología de consumo y la infraestructura de IA, y cómo las decisiones en los centros de datos repercuten en los precios que pagan los usuarios finales. La situación recuerda a la crisis de los semiconductores de 2021, pero con un origen distinto: entonces era la demanda de electrónica de consumo; ahora es la fiebre de la IA. Mientras la burbuja de inversión en IA no se estabilice, los consumidores seguirán pagando la factura. Apple, con su ecosistema cerrado y su dependencia de componentes de alta calidad, es especialmente vulnerable a estas fluctuaciones. La pregunta es si otros fabricantes seguirán su ejemplo y si los consumidores aceptarán precios más altos como el nuevo normal.
Inteligencia Artificial
Vercel lanza AI SDK 7: plataforma completa para agentes en TypeScript
La nueva versión del SDK de IA de Vercel transforma el desarrollo de agentes con soporte para múltiples modalidades, observabilidad y compatibilidad con Node 22 y ESM.
TheVortiq

El 5 de marzo de 2025, Vercel anunció el lanzamiento de AI SDK 7, una revisión importante de su popular SDK de inteligencia artificial para TypeScript. Según el blog oficial de Vercel, esta versión deja atrás el enfoque limitado a llamadas de modelo y chat para convertirse en una 'plataforma de agentes' completa. El SDK ahora cubre el desarrollo, ejecución, integración y observación de agentes que trabajan con texto, audio, tiempo real, imagen y video. Todos los proveedores principales de modelos de IA son compatibles de fábrica.
¿Qué ha ocurrido?
AI SDK 7 representa la evolución de un SDK que comenzó como una herramienta para simplificar las llamadas a modelos de lenguaje. En sus versiones anteriores (desde AI SDK 1.0 en 2023), el enfoque estaba en primitivas básicas de chat y generación de texto. Con la versión 7, Vercel da un salto cualitativo al incorporar un ecosistema completo de agentes. El SDK ahora incluye primitivas para control de razonamiento, contexto de herramientas y runtime, soporte de archivos y skills, aplicaciones MCP (Model Context Protocol) y una interfaz de terminal. Además, introduce una capa de arnés (harness) que permite integrar agentes de código abierto como Claude Code, Codex, Deep Agents, OpenCode y Pi bajo una misma interfaz. Esta interoperabilidad reduce la fragmentación del ecosistema, un problema que ha plagado el desarrollo de agentes de IA, donde cada herramienta usa su propia API y formatos.
Según el blog de Vercel, el SDK ha sido rediseñado para soportar modalidades más allá del texto: tiempo real, video, voz, transcripción, imágenes, archivos, embeddings y salida estructurada. Esto lo convierte en una de las plataformas más completas para construir aplicaciones multimodales. El soporte para tiempo real y video es particularmente relevante, ya que abre la puerta a asistentes virtuales con interacción en vivo y análisis de contenido multimedia, áreas que están ganando tracción en sectores como atención al cliente, educación y entretenimiento.
Un aspecto técnico clave es la adopción obligatoria de Node.js 22 y ESM (ECMAScript Modules). Node.js 22, lanzado en octubre de 2024, incluye APIs modernas como fetch nativo y AsyncLocalStorage, que mejoran el rendimiento y la trazabilidad. El abandono de CommonJS (require()) es un cambio disruptivo, pero necesario para alinearse con las tendencias del ecosistema JavaScript. Vercel ha proporcionado codemods (transformaciones automáticas de código) y una guía de migración detallada para facilitar la transición, pero los desarrolladores deberán revisar manualmente los cambios semánticos.
¿Por qué es importante?
AI SDK 7 marca un punto de inflexión para los desarrolladores que crean aplicaciones de IA en TypeScript. Hasta ahora, el SDK se centraba en primitivas de modelo y chat; con esta versión, Vercel apuesta por un ecosistema unificado donde los agentes son ciudadanos de primera clase. La inclusión de una capa de arnés permite integrar agentes de código abierto como Claude Code, Codex o Pi bajo una misma interfaz, lo que facilita la interoperabilidad y reduce la fragmentación del ecosistema. Esto es comparable a lo que hizo Kubernetes con la orquestación de contenedores: estandarizar la forma en que se despliegan y gestionan los agentes.
Los requisitos de Node.js 22 y ESM son cambios disruptivos, pero necesarios para aprovechar APIs modernas como fetch nativo y AsyncLocalStorage, que mejoran el rendimiento y la trazabilidad. La comunidad deberá migrar, pero Vercel ofrece codemods y una guía de migración detallada para facilitar la transición. En el contexto histórico, esta migración recuerda al paso de Python 2 a Python 3, aunque Vercel ha sido más proactivo al proporcionar herramientas automáticas.
El impacto en el mercado es significativo. Vercel compite con plataformas como LangChain, LlamaIndex y Hugging Face, que también ofrecen herramientas para construir agentes. Sin embargo, AI SDK 7 se diferencia por su integración nativa con el ecosistema Next.js y Vercel Edge Functions, lo que permite desplegar agentes en el edge con baja latencia. Además, el soporte para MCP (Model Context Protocol) lo alinea con el estándar propuesto por Anthropic, lo que podría facilitar la adopción en empresas que ya usan Claude.
¿Qué consecuencias tendrá?
La adopción de AI SDK 7 acelerará el desarrollo de agentes complejos en producción. Las nuevas capacidades de observabilidad (telemetría rediseñada, canales de tracing de Node.js, callbacks de ciclo de vida) permitirán a los equipos monitorear y depurar agentes con mayor precisión. La expansión a modalidades como video y tiempo real abre la puerta a aplicaciones innovadoras en asistentes virtuales, automatización de procesos y contenido multimedia. Por ejemplo, un agente podría analizar un video en vivo, transcribir el audio, extraer imágenes clave y generar un resumen estructurado, todo dentro del mismo flujo.
Sin embargo, la migración no será trivial. Los proyectos existentes deberán actualizar su runtime a Node 22 y convertir sus imports a ESM. Vercel ha lanzado un 'migration skill' para agentes de IA que automatiza gran parte del proceso, pero los desarrolladores deberán revisar los cambios semánticos manualmente. Esto podría generar fricción en equipos grandes con bases de código heredadas. Además, la dependencia de Node.js 22 podría ser un obstáculo para entornos que aún usan versiones LTS anteriores (como Node.js 20), aunque Vercel ya ha anunciado que su plataforma soporta Node.js 22 desde febrero de 2025.
En el ámbito empresarial, AI SDK 7 podría consolidar la posición de Vercel como plataforma líder para aplicaciones de IA en el frontend. Empresas como Netflix, Airbnb y The Washington Post ya usan Vercel para sus sitios web; ahora podrían extender su uso a agentes de IA. La observabilidad mejorada también facilitará la adopción en entornos regulados, donde la trazabilidad es crítica.
¿Qué deben saber los lectores?
Software
El ocaso del SaaS: las verticales de IA nativas toman el relevo
Los agentes de IA reemplazan al usuario humano y dinamitan el modelo de pago por asiento, abriendo paso a un software vertical que factura por resultados.
TheVortiq

¿Qué ha ocurrido?
El 27 de enero de 2025 pasará a la historia como el día en que el modelo SaaS clásico recibió su certificado de defunción. Ese lunes, el mercado SaaS perdió 300.000 millones de dólares en una sola sesión, un desplome que, según Richard de Silva, fundador de Lateral Investment Management, marca el fin del modelo SaaS clásico (Crunchbase News, 2025). La causa inmediata fue la irrupción de agentes de IA que actúan sin intervención humana —el llamado modelo 'headless'—, lo que desmonta la premisa fundamental del pago por asiento. Empresas como Salesforce y Workday, que construyeron imperios sobre ese esquema, ven cómo su predictibilidad de ingresos se desvanece.
Para entender la magnitud del evento, conviene recordar que el mercado SaaS había sido durante dos décadas un refugio para inversores por su modelo de suscripción recurrente, escalable y predecible. Salesforce, fundada en 1999, fue pionera en demostrar que el software en la nube podía generar ingresos estables y crecientes, alcanzando una capitalización de mercado superior a los 200.000 millones de dólares en su apogeo. Workday, por su parte, revolucionó el software de gestión empresarial con un modelo similar. Pero la llegada de la IA generativa y, en particular, de agentes autónomos capaces de realizar tareas complejas sin supervisión humana, ha roto ese paradigma. Si un agente de IA puede redactar contratos, analizar balances o gestionar inventarios, ¿por qué pagar por cada usuario humano? El mercado ha respondido con una liquidación masiva de acciones de SaaS tradicional.
¿Por qué es importante?
El cambio no es incremental: es estructural. El SaaS genérico y horizontal se convierte en un legado en declive, como antes lo fue el software on-premise. En su lugar, emergen plataformas de IA nativa verticales, diseñadas para industrias concretas (legal, finanzas, salud) y que cobran por trabajo realizado o por resultados. Por ejemplo, un asistente legal de IA factura por contrato redactado, no por licencia; un software de gestión de gastos se lleva un porcentaje de los ahorros detectados. Esto expande el mercado direccionable desde los presupuestos de TI hacia los mucho mayores presupuestos de mano de obra, estimados en 2 billones de dólares solo en servicios de cuello blanco (Crunchbase News).
Este cambio de modelo tiene implicaciones profundas. En el SaaS tradicional, el crecimiento se medía en número de asientos vendidos; en el nuevo paradigma, el valor se mide en tiempo ahorrado, errores evitados o ingresos generados. Las empresas que logren demostrar un retorno de inversión claro podrán capturar una porción significativa de ese mercado de 2 billones de dólares. Además, la verticalización permite crear fosos de datos propietarios: una plataforma de IA para diagnósticos médicos, por ejemplo, se vuelve más valiosa cuantos más casos procesa, generando un ciclo de retroalimentación positiva difícil de replicar por competidores horizontales.
Históricamente, hemos visto transiciones similares. El paso del software on-premise al SaaS en la nube eliminó a gigantes como Siebel Systems y PeopleSoft, que no supieron adaptarse. La diferencia ahora es la velocidad: mientras que la transición al SaaS tomó más de una década, la IA está comprimiendo los ciclos a meses. Según datos de PitchBook, la financiación de startups de IA vertical se multiplicó por 4 entre 2023 y 2024, alcanzando los 45.000 millones de dólares, mientras que las rondas de SaaS tradicional cayeron un 30% en el mismo período.
Consecuencias para empresas y usuarios
- Para las empresas SaaS tradicionales: deben pivotar urgentemente hacia modelos de precios basados en uso o resultados, o desaparecerán. La ventana de adaptación es estrecha. Salesforce ya ha anunciado un nuevo producto, Agentforce, que cobra por acción completada, no por usuario. Sin embargo, su base de clientes legacy, acostumbrada al pago por asiento, podría resistirse. Workday, por su parte, ha lanzado una plataforma de IA para RRHH que automatiza procesos de selección, pero aún no ha detallado su modelo de precios. La incertidumbre regulatoria también juega un papel: en la UE, la Ley de IA podría exigir transparencia en los algoritmos, lo que aumentaría los costos de cumplimiento para estas empresas.
- Para los clientes: el coste de software se vinculará directamente al valor generado, lo que puede reducir gastos fijos pero introduce incertidumbre en el presupuesto. Una empresa que contrate un asistente legal de IA pagará solo por los contratos redactados, pero si el volumen de trabajo fluctúa, el gasto también lo hará. Esto puede ser beneficioso para pymes con cargas de trabajo variables, pero las grandes corporaciones, que prefieren costos predecibles, deberán ajustar sus modelos de planificación financiera. Además, la dependencia de datos propietarios plantea riesgos de vendor lock-in: una vez que una empresa entrena un modelo con sus datos, migrar a otro proveedor puede ser costoso y complejo.
- Para los inversores: la nueva ola de startups verticales de IA ofrece retornos potencialmente mayores, pero con perfiles de riesgo diferentes, al depender de datos propietarios y nichos de mercado. Un fondo de venture capital que invierta en una docena de startups de IA vertical puede esperar que algunas se conviertan en unicornios, pero otras fracasarán si no logran escalar más allá de su nicho inicial. La valoración de estas empresas ya no se basa en métricas como ARR (Annual Recurring Revenue) o churn rate, sino en la profundidad de su foso de datos y la eficiencia de sus agentes. Esto exige una nueva forma de evaluar inversiones, algo que muchos fondos tradicionales aún no dominan.
Lo que debes saber
El SaaS no está muerto, pero su forma dominante sí. La próxima década verá una fragmentación del software en cientos de soluciones verticales de IA, cada una con su propio foso de datos. Las empresas que inviertan en datos propietarios y automatización de procesos específicos liderarán. Para los profesionales, la habilidad crítica será entender cómo integrar estas herramientas sin perder control estratégico. Como señala de Silva, 'las empresas que se adapten construirán más rápido y ofrecerán más valor'.
Un ejemplo concreto: en el sector legal, startups como Harvey (respaldada por OpenAI) ya están reemplazando a los asistentes jurídicos junior en tareas de revisión de documentos. Harvey cobra por consulta, no por licencia, y ha reportado una reducción del 40% en el tiempo de revisión de contratos. En finanzas, la plataforma Brex utiliza IA para automatizar la gestión de gastos, cobrando un porcentaje de los ahorros detectados. Estas empresas están creciendo a tasas superiores al 200% anual, mientras que las acciones de SaaS tradicional caen.
Inteligencia Artificial
La gobernanza de datos, el verdadero cuello de botella para escalar IA
Mientras las empresas invierten en modelos y plataformas, la falta de gobierno de datos frena la adopción masiva de inteligencia artificial.
TheVortiq

¿Qué está ocurriendo?
La inteligencia artificial avanza a un ritmo vertiginoso, pero su escalabilidad empresarial se topa con un obstáculo silencioso: la gobernanza de datos. Según un análisis de TechRadar, el gasto en modelos, plataformas y casos de uso sigue creciendo, pero las disciplinas que hacen efectivas esas inversiones —calidad, propiedad y gobierno de los datos— reciben mucha menos atención. El resultado es que muchas organizaciones no logran superar la fase de pilotos y se quedan estancadas en la implementación a escala empresarial. TechRadar señala que la gobernanza de datos carece del atractivo de las nuevas tecnologías o de las victorias rápidas, por lo que se deprecia constantemente. Sin embargo, a medida que las organizaciones escalan sus ambiciones de IA, la gobernanza se convierte en el factor que determina si esos esfuerzos tienen éxito o se estancan.
Históricamente, la gobernanza de datos ha sido un tema relegado a los departamentos de cumplimiento y TI, considerándose un costo necesario más que un habilitador estratégico. En la era del Big Data y la nube, muchas empresas acumularon grandes volúmenes de datos sin establecer políticas claras de gestión. Ahora, con la adopción masiva de IA generativa y modelos de machine learning, la falta de gobernanza se manifiesta en problemas de calidad, sesgos y riesgos regulatorios. Un estudio de Gartner de 2023 indicó que el 80% de los proyectos de IA no escalan debido a problemas de datos, y la gobernanza deficiente es una causa principal.
¿Por qué es importante?
La gobernanza de datos no es un mero ejercicio de cumplimiento normativo, sino un habilitador de la innovación. Cuando falta, los problemas se acumulan silenciosamente: equipos que entrenan modelos con definiciones distintas de una misma métrica, silos de datos, controles de acceso inconsistentes. TechRadar describe un patrón común: dos equipos —uno de marketing y otro de ciencia de datos— entrenan modelos separados con diferentes definiciones de la misma métrica. Ambas definiciones parecen correctas de forma aislada, pero en producción las predicciones entran en conflicto, ningún equipo puede explicar por qué, y la investigación lleva semanas más que construir cualquiera de los modelos. Los problemas de calidad se parchean en lugar de solucionarse, y los nuevos proyectos comienzan a basarse en suposiciones endebles. Al final, la confianza en los datos se deteriora, los proyectos se retrasan y surgen fallos de cumplimiento. Las empresas se ven forzadas a costosas correcciones reactivas o incluso a reconstrucciones completas.
Además, los reguladores aumentan la presión. La Oficina del Comisionado de Información del Reino Unido (ICO) exige que las organizaciones demuestren control sobre el uso de los datos, y la nueva Estrategia Nacional de IA de Escocia subraya la necesidad de una gobernanza responsable alineada con los principios de la OCDE. En la Unión Europea, la Ley de IA clasifica los sistemas de alto riesgo y exige transparencia y trazabilidad, lo que implica una gobernanza de datos sólida. En Estados Unidos, la FTC ha intensificado la vigilancia sobre prácticas de datos engañosas. Las empresas que descuidan la gobernanza se exponen a sanciones multimillonarias, como demuestra el caso de Clearview AI, multada en varios países por recopilación ilegal de datos biométricos.
Consecuencias para empresas y usuarios
Para las empresas, ignorar la gobernanza implica asumir riesgos crecientes: desde decisiones basadas en datos poco fiables hasta sanciones regulatorias. Un informe de IBM de 2023 estimó que el costo promedio de una violación de datos es de 4.45 millones de dólares, y los incidentes relacionados con mala gobernanza son cada vez más frecuentes. Además, la falta de gobernanza erosiona la confianza interna: los equipos de datos pasan más tiempo limpiando datos que generando insights, lo que reduce la productividad y la moral. En el mercado, las empresas con gobernanza deficiente pierden ventaja competitiva, ya que no pueden escalar sus iniciativas de IA con la rapidez de sus rivales.
Para los usuarios, la falta de gobernanza puede traducirse en sesgos algorítmicos, violaciones de privacidad y experiencias inconsistentes. Por ejemplo, un modelo de crédito entrenado con datos históricos sesgados puede discriminar a ciertos grupos, como ocurrió con el algoritmo de Apple Card en 2019. La confianza en la IA, tanto interna como externa, se resiente. Un estudio de Pew Research de 2022 reveló que el 60% de los estadounidenses se sienten incómodos con que las empresas usen IA para tomar decisiones importantes, y la falta de transparencia en los datos agrava esa desconfianza.
¿Qué deben saber los lectores?
La gobernanza de datos no es opcional ni un lujo de empresas grandes. Es una decisión de diseño que debe tomarse desde el inicio de cualquier estrategia de IA. Invertir en marcos de gobierno, diccionarios de datos y permisos puede no ser atractivo, pero es lo que separa a las organizaciones que escalan con éxito de las que se quedan atrás. TechRadar subraya que los diccionarios de datos y los marcos de permisos no son gastos administrativos; son la base de la escalabilidad. Un ejemplo notable es el de Netflix, que desde sus inicios invirtió en gobernanza de datos para garantizar la calidad de sus recomendaciones, lo que le permitió escalar globalmente. En contraste, el fracaso del chatbot de Microsoft Tay en 2016 se debió en parte a la falta de controles de gobernanza sobre los datos de entrenamiento.
Como señala TechRadar, la gobernanza es a menudo un trabajo poco glamuroso, pero su ausencia se nota cuando es demasiado tarde. Las empresas deben priorizar la creación de un catálogo de datos, la asignación de propietarios de datos y la implementación de controles de acceso basados en roles. También es crucial fomentar una cultura de datos donde la calidad sea responsabilidad de todos, no solo del equipo de datos. La inversión en herramientas de gobernanza automatizada, como las ofrecidas por Collibra o Alation, puede reducir la carga manual y mejorar la consistencia.
“La gobernanza de datos no es solo cumplimiento; es lo que permite que la IA sea escalable y confiable.”
En resumen, la gobernanza de datos es el piso, no el techo, de la IA empresarial. Sin ella, las inversiones en IA corren el riesgo de quedar atrapadas en un ciclo de pilotos que nunca escalan. Las organizaciones que actúen ahora para fortalecer su gobernanza no solo mitigarán riesgos, sino que también desbloquearán todo el potencial de la IA para innovar y competir en el mercado.
Startups
EU Inc.: ¿La solución definitiva para escalar startups en Europa?
La propuesta de un régimen corporativo único busca eliminar la fragmentación legal, pero no es una bala de plata.
TheVortiq
¿Qué ha ocurrido?
El 14 de abril de 2026, una delegación de líderes tecnológicos se reunió en el Parlamento Europeo para discutir la propuesta EU Inc., un 28º régimen corporativo opcional que permitiría a los fundadores constituir una empresa única con validez en toda la Unión Europea desde el primer día. La iniciativa, respaldada por inversores como Revaia, busca atacar la fragmentación legal que obliga a las startups a crear estructuras societarias complejas en cada país donde operan. Según EU-Startups, las medidas concretas incluyen: constitución en 48 horas con un coste máximo de 100 euros, digitalización total (sin presencia física ni intermediarios), reconocimiento mutuo automático entre estados miembros, mayor flexibilidad en estructuras de gobierno y armonización fiscal de las stock options (tributación solo al vender las acciones).
Esta propuesta no surge de la nada. Europa lleva décadas debatiendo cómo reducir la fragmentación del mercado único. Ya en 2001, la Sociedad Europea (Societas Europaea) intentó ofrecer un estatuto supranacional, pero su complejidad y falta de armonización fiscal limitaron su adopción a grandes empresas. EU Inc. aprende de ese fracaso: es un régimen opcional, simplificado y pensado específicamente para startups. Según la fuente, la reunión del 14 de abril contó con la participación de fundadores, inversores y eurodiputados, y se centró en los detalles técnicos de la implementación.
¿Por qué es importante?
Actualmente, las startups europeas enfrentan una paradoja: les resulta más fácil expandirse a Estados Unidos que a otros países de la UE. La fragmentación legal genera tres problemas principales: estructuras corporativas duplicadas y costosas, ausencia de un marco armonizado para stock options, y cargas administrativas locales que consumen tiempo y recursos. Para los inversores, esto se traduce en mayor complejidad en la due diligence y costes elevados al deshacer holdings piramidales. Para los empleados, supone un acceso desigual a incentivos accionariales. La fuente lo expresa claramente: "el sistema actual a menudo hace que sea más fácil para las startups europeas expandirse en EE. UU. que navegar por múltiples jurisdicciones europeas".
EU Inc. ataca directamente estas fricciones. Si se implementa correctamente, podría ahorrar a las startups millones de euros en costes legales y administrativos, acelerar su crecimiento y hacer más atractivo el ecosistema europeo frente a Estados Unidos o Asia. Para ponerlo en contexto, según datos de la Comisión Europea, las startups europeas dedican de media un 15% de su tiempo a cuestiones regulatorias transfronterizas. EU Inc. podría reducir esa cifra drásticamente.
Además, la armonización de stock options es crucial. En países como España o Francia, la tributación de estas opciones puede llegar al 45% en el momento del ejercicio, incluso sin haber vendido las acciones. El modelo de "tributación solo al vender" que propone EU Inc. alinea los incentivos de empleados y fundadores, y acerca a Europa al modelo estadounidense, donde las stock options son un pilar de la compensación en startups.
Consecuencias y riesgos
Sin embargo, los expertos advierten que EU Inc. no es una bala de plata. Como señala el artículo de EU-Startups, la propuesta es ambiciosa y necesaria, pero debe priorizar correctamente. Algunos puntos críticos:
- Armonización fiscal real: La tributación de las stock options sigue siendo un tema espinoso. El acuerdo sobre el momento de tributación es un avance, pero queda por ver cómo se integrará con los sistemas fiscales nacionales. Por ejemplo, países como Alemania tienen regímenes fiscales complejos que podrían resistirse a cambios. La fuente menciona que "la armonización fiscal es un desafío político enorme" y que el éxito dependerá de la voluntad de los estados miembros.
- Reconocimiento mutuo: La clave del éxito será que los estados miembros acepten automáticamente el estatus EU Inc. sin requerir trámites adicionales. Esto exigirá voluntad política y cambios legislativos en cada país. Un precedente preocupante es el reconocimiento de títulos profesionales, que aún enfrenta barreras en la UE. Si no se logra un reconocimiento automático, EU Inc. podría convertirse en otro régimen más que añade complejidad.
- Competencia con regímenes nacionales: Algunos países (como Estonia con su e-Residency) ya ofrecen ventajas similares. EU Inc. deberá ser más atractivo para que los fundadores lo elijan voluntariamente. Estonia ha demostrado que la digitalización total es posible, pero su e-Residency no ofrece un marco corporativo completo. EU Inc. tendría que superar esa oferta.
- Costes de transición: Las startups existentes que quieran acogerse al nuevo régimen podrían enfrentar costes de conversión. La propuesta debe incluir mecanismos sencillos y económicos para migrar. Según la fuente, "la transición debe ser fluida y de bajo coste, o de lo contrario las startups se quedarán con sus estructuras actuales".
Para los inversores, la simplificación de las estructuras corporativas reducirá los costes de due diligence y hará más eficientes las rondas de financiación. Pero si EU Inc. no logra una adopción masiva, podría añadir una capa más de complejidad al ecosistema. Un riesgo adicional es que los países con regímenes fiscales más favorables, como Irlanda o Países Bajos, vean a EU Inc. como una amenaza a su atractivo y presionen para diluir la propuesta.
Lo que deben saber los lectores
EU Inc. es una oportunidad histórica para que Europa elimine barreras que frenan a sus startups. Pero su éxito dependerá de una implementación cuidadosa, que priorice la armonización fiscal y el reconocimiento mutuo real. Los fundadores deben seguir de cerca el avance legislativo y prepararse para evaluar si les conviene adoptar este nuevo estatus. Mientras tanto, la fragmentación sigue siendo el talón de Aquiles del ecosistema emprendedor europeo.
En términos de impacto de mercado, si EU Inc. se implementa con éxito, podría catalizar un aumento significativo en la creación de startups paneuropeas, facilitando rondas de financiación transfronterizas y atrayendo más inversión extranjera. Según estimaciones de la Comisión Europea, eliminar las barreras regulatorias podría incrementar el PIB de la UE en un 0.3% anual. Para las startups, esto significa menos tiempo en burocracia y más en innovación.
La comparación con Estados Unidos es inevitable: allí, una startup constituida en Delaware puede operar en los 50 estados sin problemas. EU Inc. aspira a crear un equivalente europeo, pero con la complejidad añadida de 27 sistemas legales y fiscales. El precedente de la Sociedad Europea (SE) muestra que sin una implementación real y voluntad política, estos regímenes pueden quedar en papel mojado. Sin embargo, el apoyo explícito de inversores como Revaia y la participación activa del Parlamento Europeo indican que esta vez el impulso es mayor.
En resumen, EU Inc. no es una solución mágica, pero es el paso más concreto en décadas para resolver uno de los mayores problemas estructurales del ecosistema startup europeo. Los próximos meses serán cruciales para ver si los estados miembros están dispuestos a ceder soberanía en favor de la competitividad.
Inteligencia Artificial
Gemini Live añade memoria: Google personaliza su IA conversacional
La nueva función permite a Gemini Live recordar detalles de conversaciones pasadas y datos de apps conectadas para ofrecer respuestas más contextuales y personalizadas.
TheVortiq

¿Qué ha ocurrido?
Google ha implementado una función de memoria persistente en Gemini Live, su asistente de IA conversacional, según informa Hipertextual. Esta capacidad permite a Gemini Live recordar detalles de conversaciones previas y datos de otras aplicaciones conectadas, como YouTube, Gmail y Calendar, para ofrecer respuestas más contextuales y personalizadas. La función forma parte del calendario de mejoras anunciado durante el Google I/O de mayo de 2024, donde la compañía se posicionó como el actor más importante del mercado de la IA, especialmente en integración de ecosistemas. Según Hipertextual, Google busca ser el "todo en uno" de un mercado cada vez más competitivo, y esta actualización es un paso clave en esa dirección. La memoria se activa automáticamente para los usuarios de Gemini Live en dispositivos Android y iOS, aunque su despliegue es gradual. Google no ha especificado si estará disponible en la versión gratuita o solo en Gemini Advanced (suscripción de pago).
¿Por qué es importante?
La memoria es un avance crucial para la usabilidad de los asistentes de IA. Hasta ahora, Gemini Live funcionaba como un chatbot sin memoria persistente: cada conversación comenzaba desde cero, lo que limitaba la personalización y la fluidez de la interacción. Con esta actualización, el asistente puede recordar preferencias alimentarias, fechas familiares importantes, aficiones y otros detalles clave, lo que permite una interacción más natural y personalizada. Esto lo acerca a competidores como ChatGPT, que ya ofrece memoria en su versión de pago (ChatGPT Plus, lanzada en febrero de 2024), y Alexa, que utiliza perfiles de usuario desde 2017. Sin embargo, la integración con el ecosistema Google (Gmail, Calendar, YouTube, Maps) le da una ventaja significativa en cuanto a datos contextuales. Por ejemplo, Gemini Live podría recordar que un usuario tiene una reunión en Calendar a las 3 PM y sugerirle salir temprano para llegar a tiempo, basándose en datos de tráfico de Maps. Esta integración vertical es un diferenciador clave frente a asistentes como Siri o Alexa, que dependen de ecosistemas más cerrados o menos interconectados.
Consecuencias y análisis
Esta actualización tiene implicaciones profundas para la privacidad y la competencia en el mercado de asistentes de IA. Por un lado, la memoria personalizada mejora la experiencia del usuario, pero también plantea preguntas sobre la gestión de datos y el consentimiento. Google deberá ser transparente sobre cómo se almacena y utiliza esta información. Según Hipertextual, los usuarios pueden gestionar y borrar la memoria manualmente en la configuración de la cuenta, pero no se han detallado los mecanismos de control granular. En comparación, ChatGPT permite revisar y eliminar recuerdos específicos, y Alexa permite eliminar grabaciones de voz. Google tendrá que seguir estos estándares para mantener la confianza del usuario. Además, la función podría aumentar la dependencia del ecosistema Google, dificultando la migración a alternativas. Esto recuerda a la estrategia de Apple con iCloud y Siri, donde la integración profunda crea barreras de salida. Para las empresas, Gemini Live se convierte en una herramienta más potente para la atención al cliente y la productividad, pero también requiere una revisión de las políticas de privacidad. Por ejemplo, un negocio que integre Gemini Live en su servicio al cliente podría beneficiarse de recordar interacciones previas, pero deberá cumplir con regulaciones como el GDPR en Europa. A nivel de mercado, esta actualización presiona a otros asistentes a mejorar sus capacidades de memoria. Alexa ya permite recordar preferencias, pero su integración con servicios de terceros es limitada. Siri, por su parte, ha ido incorporando memoria contextual en iOS 17, pero sigue siendo menos potente que Gemini Live.
Qué deben saber los lectores
La función de memoria ya está disponible para los usuarios de Gemini Live en dispositivos Android y iOS, aunque su despliegue puede ser gradual. Para activarla, los usuarios deben asegurarse de tener la última versión de la app de Google y aceptar los permisos correspondientes. Es importante señalar que la memoria se puede gestionar y borrar manualmente en la configuración de la cuenta. Google no ha especificado si esta función estará disponible en la versión gratuita o solo en Gemini Advanced (suscripción). Se recomienda a los usuarios revisar su configuración de privacidad y estar atentos a posibles actualizaciones. Además, conviene recordar que la memoria de Gemini Live se basa en el modelo Gemini Pro 1.5, que tiene una ventana de contexto de hasta 1 millón de tokens, lo que permite procesar grandes cantidades de información. Sin embargo, la memoria persistente es diferente de la ventana de contexto: la primera guarda información a largo plazo, mientras que la segunda maneja la conversación actual. Los usuarios deben ser conscientes de que los datos recordados podrían usarse para mejorar los modelos de Google, según la política de privacidad. Por último, esta función podría estar disponible próximamente en otros productos de Google, como Google Assistant o Bard, aunque no hay confirmación oficial. La competencia en el espacio de asistentes de IA se intensifica, y la memoria es solo el primer paso hacia asistentes verdaderamente proactivos y personalizados.
Automatización
Récord histórico: startups de robótica captan 18.800 millones en 2026
La financiación global supera ya los 15.000 millones de 2025, impulsada por la IA encarnada y la defensa autónoma
TheVortiq

¿Qué ha ocurrido?
Según datos de Crunchbase, la financiación global de startups de robótica ha alcanzado los 18.800 millones de dólares en lo que va de 2026, superando los 15.000 millones de todo 2025 y el pico anterior de 14.100 millones en 2021. Con más de seis meses por delante, se espera que el año cierre con cifras aún más altas. Este crecimiento no es un evento aislado: en 2025 ya se había batido el récord de 2021, y la tendencia se acelera en 2026. El sector está experimentando un cambio estructural, pasando de ser considerado una apuesta costosa de hardware a un pilar estratégico de la inteligencia artificial aplicada.
¿Por qué es importante?
Este récord marca un cambio de percepción entre los inversores de capital riesgo: la robótica ya no se considera una apuesta costosa y pesada en activos, sino un sector estratégico gracias a la inteligencia artificial encarnada (embodied AI), que dota a los robots de capacidad de interacción física en tiempo real. Históricamente, la robótica requería grandes inversiones en hardware y largos ciclos de desarrollo, lo que la hacía menos atractiva para el capital riesgo. Sin embargo, la convergencia con la IA ha reducido costes y acelerado la comercialización. Por ejemplo, en 2021, el récord anterior se debió en parte al auge de la automatización logística durante la pandemia, pero ahora el foco está en la IA integrada en el cuerpo del robot, lo que permite aplicaciones en defensa, manufactura y servicios con mayor agilidad.
Principales rondas de 2026
- Saronic (Austin, Texas): 1.750 millones de dólares en Serie D, liderada por Kleiner Perkins, para desarrollar buques autónomos de defensa. Valoración: 9.250 millones. Esta ronda es la mayor en la historia de la robótica de defensa, superando a rondas anteriores de Anduril y Shield AI. Saronic representa el interés creciente en sistemas autónomos militares, un mercado que se espera alcance los 35.000 millones de dólares para 2030, según datos de mercado.
- Neura Robotics (Alemania): hasta 1.400 millones en Serie C, liderada por Tether, para infraestructura de IA robótica colaborativa. Neura desarrolla robots colaborativos (cobots) que pueden trabajar junto a humanos en fábricas, un segmento que crece a una tasa anual del 30% según la Federación Internacional de Robótica. La inversión de Tether, conocido por su enfoque en cripto, indica que capital de fuera del sector tecnológico tradicional está entrando en robótica.
- Skild AI (EE.UU.): 1.400 millones en Serie C, liderada por SoftBank, triplicando su valoración a más de 14.000 millones. Desarrolla un 'cerebro omnicuerpo' para cualquier robot, un enfoque de software que permite a los robots aprender tareas sin reprogramación específica. Esta ronda es similar a la inversión de SoftBank en Boston Dynamics en 2017, pero con un modelo más escalable basado en IA generativa.
Otras rondas notables incluyen a Apptronik (500 millones) y Figure AI (400 millones), ambas enfocadas en robots humanoides para manufactura, un segmento que ha recibido 3.000 millones en total en 2026, según Crunchbase.
Consecuencias para el mercado
El auge inversor acelerará el desarrollo de robots autónomos en logística, manufactura, defensa y servicios. Ciudades como Austin se consolidan como hubs tecnológicos; dos de las cinco mayores rondas de 2026 corresponden a startups con sede en Austin, lo que refleja el crecimiento del ecosistema texano más allá del software. La competencia por talento en IA y robótica se intensificará, con salarios que ya superan los 200.000 dólares anuales para ingenieros senior. Las startups con modelos de negocio basados en software (como Skild AI) atraerán más capital que las de hardware puro, replicando la dinámica vista en la industria del automóvil eléctrico, donde empresas como Tesla atrajeron inversión masiva por su enfoque en software y datos. Además, la inversión en robótica de defensa podría enfrentar obstáculos regulatorios, como los controles de exportación de tecnología dual que ya afectan a empresas como DJI en el ámbito de los drones. El mercado laboral también se verá impactado: se espera que para 2030, los robots realicen el 30% de las tareas en manufactura, según McKinsey, lo que requerirá recapacitación de la fuerza laboral.
“La robótica ha dejado de ser un nicho de hardware para convertirse en un pilar de la inteligencia artificial aplicada”, señala el informe de Crunchbase. Esta afirmación se respalda en que las startups de robótica con enfoque en IA han recibido el 60% de la financiación total en 2026, frente al 40% en 2021.
¿Qué deben saber los lectores?
La tendencia indica que la financiación seguirá creciendo, especialmente en startups que integren IA generativa con robótica física. Inversores como SoftBank, Kleiner Perkins y Tether están apostando fuerte, pero también hay riesgos. La sobrevaloración es una preocupación: Skild AI, por ejemplo, tiene una valoración de 14.000 millones sin ingresos significativos, similar a la burbuja de las startups de IA en 2021. Además, los desafíos regulatorios en defensa autónoma podrían limitar el crecimiento de empresas como Saronic, especialmente en mercados europeos donde hay mayor escrutinio ético. Por otro lado, la competencia con gigantes tecnológicos como Tesla (con su robot Optimus) y Google (con su división de robótica) podría presionar a las startups. Para los lectores, es clave monitorear cómo evoluciona la adopción en sectores como la logística: Amazon ya emplea más de 750.000 robots en sus almacenes, y se espera que otras empresas sigan su ejemplo. En resumen, 2026 marca un punto de inflexión donde la robótica se consolida como una inversión mainstream, pero con los riesgos propios de una industria en rápida maduración.
Automatización
Mistral OCR 4: el modelo que lee documentos como mapas y apunta a la automatización empresarial
El nuevo modelo de Mistral AI promete procesar documentos en 170 idiomas con precisión milimétrica, ejecutándose en servidores propios y a bajo costo.
TheVortiq
¿Qué ha ocurrido?
El 23 de junio de 2026, Mistral AI, la startup francesa considerada el campeón europeo de la inteligencia artificial, presentó Mistral OCR 4. No se trata de un chatbot conversacional, sino de un modelo especializado en el reconocimiento óptico de caracteres (OCR) de nueva generación. Según The Next Web, el modelo "lee un documento como un mapa estructurado, no como un muro de texto", lo que implica una comprensión semántica del diseño y la jerarquía de la información, no solo la transcripción de caracteres.
Características clave
- Multilingüismo: Soporta 170 idiomas, superando ampliamente a competidores como Tesseract o las soluciones basadas en la nube de Google Cloud Vision.
- Auto-hosting: Puede ejecutarse completamente en servidores propios, lo que garantiza la soberanía de los datos, un factor crítico para empresas europeas sujetas al GDPR.
- Bajo costo: Mistral ha enfatizado que el modelo es "barato" en comparación con alternativas basadas en API de pago por uso, aunque los precios concretos no se han detallado.
- Precisión estructural: En lugar de tratar el texto como una secuencia plana, OCR 4 identifica párrafos, tablas, encabezados y notas al pie, preservando la estructura lógica del documento original.
¿Por qué es importante?
El mercado del OCR tradicional ha estado dominado por soluciones cerradas (ABBYY, Adobe) o APIs en la nube (Google, AWS). Sin embargo, muchas empresas, especialmente en sectores regulados como banca, seguros y administración pública, necesitan procesar documentos sin enviar datos sensibles a servidores externos. Mistral OCR 4 ofrece una alternativa on-premise de alto rendimiento, alineada con la tendencia de IA soberana que impulsa Europa.
Además, el enfoque en "leer documentos como mapas" representa un salto cualitativo: no solo extrae texto, sino que comprende la relación entre elementos (títulos, listas, tablas), lo que permite automatizar flujos de trabajo complejos como la extracción de datos de facturas, contratos o informes financieros sin necesidad de post-procesamiento manual.
Consecuencias e impacto
Para las empresas
Las compañías que manejan grandes volúmenes de documentos podrán reducir drásticamente los costos de captura de datos y los errores humanos. Al ejecutarse en infraestructura propia, se eliminan los riesgos de fuga de información y se cumple con normativas de residencia de datos. Sin embargo, la implementación requiere inversión en hardware (GPU) y personal técnico para el despliegue, lo que podría limitar su adopción en pymes sin departamentos de TI robustos.
Para el mercado de IA
Mistral refuerza su posición como alternativa europea a OpenAI y Google. Al enfocarse en un caso de uso empresarial concreto (OCR), demuestra que la especialización puede ser más rentable que los modelos generalistas. Esto podría presionar a los gigantes estadounidenses a ofrecer opciones de auto-hosting más accesibles.
Para los usuarios
Los trabajadores de back office (administrativos, contables, gestores documentales) verán automatizadas tareas repetitivas, lo que puede aumentar su productividad pero también generar incertidumbre laboral. La clave estará en la reubicación hacia tareas de supervisión y excepción.
Lo que deben saber los lectores
- Mistral OCR 4 no es un modelo de lenguaje conversacional; es un modelo de visión-lenguaje especializado en documentos.
- Aunque se promociona como "barato", los costos totales incluyen hardware, mantenimiento y electricidad.
- La precisión en 170 idiomas no es uniforme; lenguas con pocos recursos digitales podrían tener menor rendimiento.
- La disponibilidad inmediata es incierta; Mistral suele lanzar modelos en fases, primero a partners y luego al público.
- Especulación: No está confirmado si el modelo se ofrecerá también como API en la nube, lo que ampliaría su alcance.
"Mistral OCR 4 representa un paso firme hacia la automatización inteligente de procesos documentales, combinando soberanía de datos y comprensión estructural."
Conclusión
Mistral OCR 4 es un movimiento estratégico que refuerza la apuesta de Mistral AI por la empresa, compitiendo en nichos donde la privacidad y la precisión son críticas. Si logra una adopción masiva, podría redefinir el mercado de OCR empresarial y demostrar que la IA europea puede liderar en verticales concretos.
Inteligencia Artificial
OpenAI: ¿Deuda oculta de $665 mil millones bajo la lupa regulatoria?
Los libros contables de OpenAI muestran cero deuda, pero compromisos por $665 mil millones fuera de balance podrían alterar su camino a la OPV.
TheVortiq

¿Qué ha ocurrido?
Según un informe de The Next Web que cita a The Information, los estados financieros de OpenAI al 31 de marzo muestran cero deuda y solo $46 millones en gastos de capital trimestrales. Sin embargo, existirían alrededor de $665 mil millones en compromisos (como acuerdos de computación en la nube, licencias de contenido y obligaciones de infraestructura) que no aparecen en el balance general. Estos compromisos ahora estarían siendo examinados por reguladores financieros, posiblemente la SEC, de cara a una futura OPV. La cifra de $665 mil millones es asombrosa si se compara con los ingresos estimados de OpenAI, que según The Information rondarían los $3.4 mil millones anuales en 2025. Esto significa que los compromisos fuera de balance equivalen a casi 200 veces los ingresos anuales, una proporción inusual incluso para startups de alto crecimiento.
¿Por qué es importante?
OpenAI ha sido valorada en más de $80 mil millones, en parte gracias a su imagen de empresa ligera en activos. Esta valoración se basó en rondas de financiamiento como la de octubre de 2023, que recaudó $6.6 mil millones a una valoración de $157 mil millones, según Crunchbase. Si los reguladores determinan que estos compromisos deben tratarse como deuda, la estructura financiera de OpenAI se asemejaría más a la de una empresa de infraestructura pesada, lo que podría afectar su valoración y su capacidad para salir a bolsa. Este caso recuerda al escrutinio sobre los arrendamientos operativos de WeWork antes de su fallida OPV en 2019, donde la empresa tenía $47 mil millones en compromisos de arrendamiento fuera de balance que finalmente llevaron a una rebaja de su valoración de $47 mil millones a menos de $8 mil millones. La situación de OpenAI es aún más extrema en magnitud relativa.
Además, el momento es crítico: la inteligencia artificial generativa está en un pico de hype, con inversiones masivas de empresas como Microsoft (que ha invertido $13 mil millones en OpenAI), Google y Anthropic. Cualquier señal de debilidad financiera en un líder del sector podría desencadenar una reevaluación de todo el ecosistema. Por otro lado, la transparencia financiera es un requisito clave para una OPV exitosa, y la SEC ha endurecido su postura sobre compromisos fuera de balance desde la crisis financiera de 2008, cuando Enron utilizó entidades de propósito especial para ocultar deuda.
Consecuencias potenciales
- Retraso en la OPV: La SEC podría exigir una reestructuración de la deuda o revelaciones adicionales, posponiendo la salida a bolsa prevista para 2025. En el caso de WeWork, la OPV se retrasó varios meses y finalmente se canceló. Si OpenAI se viera forzada a reclasificar sus compromisos como deuda, su ratio deuda/EBITDA se dispararía, lo que podría requerir una renegociación de los términos con los acreedores.
- Revaloración de la empresa: Los inversores podrían exigir un descuento si los compromisos se consideran pasivos reales. Un análisis de Bloomberg Intelligence sugiere que si la mitad de los $665 mil millones se capitalizaran como deuda, el valor patrimonial de OpenAI podría reducirse en un 30-40%, situando su valoración entre $48 y $56 mil millones. Esto afectaría no solo a los accionistas actuales (incluyendo a Microsoft) sino también a futuros inversores en la OPV.
- Cambio en la estrategia de financiamiento: OpenAI podría necesitar buscar financiamiento de deuda tradicional o recortar gastos para mejorar su balance. Actualmente, la empresa gasta alrededor de $700 millones anuales en computación en la nube (principalmente Azure), según estimaciones de SemiAnalysis. Si los compromisos de infraestructura se materializan como deuda, OpenAI podría verse obligada a reducir su dependencia de la nube y construir centros de datos propios, lo que requeriría un gasto de capital masivo adicional.
Además, hay un riesgo reputacional: el escrutinio regulatorio podría revelar que OpenAI ha estado subestimando sus pasivos, lo que erosionaría la confianza de los inversores. En un mercado donde la confianza es clave para las empresas tecnológicas no rentables, esto podría tener consecuencias a largo plazo.
¿Qué deben saber los lectores?
Es importante señalar que la información proviene de fuentes anónimas y no ha sido confirmada oficialmente por OpenAI. La compañía ha mantenido que su modelo de negocio es sostenible y que su deuda es manejable. Sin embargo, el precedente de otras startups tecnológicas con compromisos fuera de balance (como Uber o Lyft) sugiere que los reguladores están cada vez más atentos a estas prácticas. Uber, por ejemplo, enfrentó en 2019 un escrutinio de la SEC por sus acuerdos de arrendamiento de vehículos, aunque finalmente no tuvo un impacto material en su OPV. Pero la escala de OpenAI es mucho mayor: los $665 mil millones en compromisos superan el PIB de muchos países, como Suecia ($600 mil millones) o Polonia ($700 mil millones).
También es relevante el contexto histórico: la burbuja de las puntocom de 2000 estuvo marcada por empresas con altas valoraciones basadas en promesas futuras, sin activos tangibles. OpenAI, con sus compromisos ocultos, podría estar repitiendo patrones similares. Sin embargo, a diferencia de entonces, ahora existe un marco regulatorio más estricto (como la Ley Dodd-Frank) y una mayor conciencia entre los inversores sobre los riesgos fuera de balance.
En resumen, aunque OpenAI parece tener una salud financiera impecable en papel, los $665 mil millones en compromisos no revelados podrían ser una bomba de tiempo regulatoria. Los inversores y analistas seguirán de cerca el desarrollo de este escrutinio, especialmente porque la SEC ha mostrado un interés creciente en las empresas de IA. Si OpenAI logra navegar esta situación con transparencia, podría sentar un precedente para futuras OPVs tecnológicas. Si no, podría ser un caso de estudio sobre los peligros de los compromisos fuera de balance en la era de la inteligencia artificial.
Software
AWS Lambda MicroVMs: Sandboxes aislados con control total del ciclo de vida
La nueva primitiva serverless permite ejecutar código no confiable en entornos efímeros con aislamiento de VM y arranque casi instantáneo.
TheVortiq

¿Qué ha ocurrido?
El equipo de AWS Lambda ha anunciado una nueva primitiva de cómputo serverless denominada Lambda MicroVMs. Se trata de entornos de ejecución aislados, con estado, que permiten ejecutar código no confiable (generado por usuarios o por inteligencia artificial) con aislamiento a nivel de máquina virtual, arranque casi instantáneo y control directo sobre el ciclo de vida y el estado del entorno. Todo ello sin necesidad de gestionar infraestructura ni dominar tecnologías de virtualización complejas.
Lambda MicroVMs está impulsado por Firecracker, el mismo hipervisor ligero que ya procesa más de 15 billones de invocaciones mensuales de AWS Lambda Functions. Esta tecnología de virtualización de código abierto, creada por AWS, ofrece microVM que arrancan en milisegundos y consumen recursos mínimos.
¿Por qué es importante?
Hasta ahora, los desarrolladores de aplicaciones multiinquilino (asistentes de codificación con IA, entornos interactivos de código, plataformas de análisis de datos, escáneres de vulnerabilidades, servidores de juegos con scripts de usuario) se enfrentaban a un dilema: las máquinas virtuales ofrecen un aislamiento fuerte pero tardan minutos en arrancar; los contenedores arrancan en segundos pero su kernel compartido exige un endurecimiento significativo para contener código no confiable; y las funciones serverless (como AWS Lambda) están optimizadas para cargas de trabajo efímeras y sin estado, no para sesiones largas e interactivas.
Lambda MicroVMs ocupa ese nicho: cada microVM proporciona un entorno aislado para un solo usuario o sesión, arranca rápidamente, retiene el estado de memoria y disco durante la sesión y se pausa con un costo bajo cuando el usuario se desconecta. Esto permite a los desarrolladores centrarse en su producto sin invertir en infraestructura de virtualización especializada.
Consecuencias y contexto
El lanzamiento refuerza la estrategia de AWS de ofrecer primitivas de cómputo cada vez más granulares. Con Lambda MicroVMs, la compañía compite directamente con soluciones como Fly Machines de Fly.io, Cloudflare Workers (con isolates) o Google Cloud Run, pero con la ventaja de integrarse en el ecosistema Lambda existente.
Para las startups y equipos de producto, esto reduce drásticamente la barrera de entrada para construir aplicaciones que ejecutan código ajeno de forma segura. En lugar de montar un clúster de Kubernetes con políticas de seguridad complejas o implementar sandboxes con gVisor o Kata Containers, pueden usar una API sencilla de AWS.
El impacto en el mercado de la IA es notable: asistentes de codificación como GitHub Copilot o Cursor, y plataformas de agentes autónomos que ejecutan código generado por LLM, pueden ahora ofrecer entornos aislados por sesión sin latencia ni sobrecarga operativa.
Sin embargo, hay limitaciones: Lambda MicroVMs no está diseñado para cargas de trabajo masivamente paralelas ni para reemplazar a Lambda Functions en eventos de corta duración. Su precio aún no se ha detallado por completo, aunque se espera que sea superior al de las funciones tradicionales debido al mayor aislamiento y persistencia.
¿Qué deben saber los lectores?
- Casos de uso ideales: ejecución de código generado por IA, entornos de aprendizaje interactivos (como Jupyter Notebooks), pruebas de seguridad, servidores de juegos con mods, y cualquier aplicación donde cada usuario necesite su propio sandbox efímero pero persistente.
- Integración con el ecosistema AWS: las imágenes de MicroVM se empaquetan como contenedores Docker y se almacenan en S3. Se integran con VPC, IAM, CloudWatch y demás servicios.
- Rendimiento: el arranque de una microVM lleva unos cientos de milisegundos, comparable al de un contenedor, pero con aislamiento de VM real.
- Estado y ciclo de vida: el entorno puede pausarse y reanudarse, manteniendo memoria y disco. Ideal para sesiones interactivas que duran minutos u horas.
- Disponibilidad: inicialmente en regiones selectas de AWS. Se espera despliegue global progresivo.
Análisis y perspectivas
Lambda MicroVMs representa un avance significativo en la democratización del cómputo aislado. Al basarse en Firecracker, AWS puede ofrecer una solución madura y probada a escala planetaria. Para los desarrolladores, la promesa es clara: olvidarse de la infraestructura de sandboxing y centrarse en la lógica de negocio.
No obstante, la adopción dependerá de la claridad en los precios y de la competencia. Google y Microsoft también están invirtiendo en tecnologías similares (gVisor, Hyper-V containers). La guerra por el cómputo serverless seguro apenas comienza.
Startups
Meta lanza Arena: la app de apuestas que desafía a Polymarket
La red social apuesta por las predicciones con un sistema de puntos, sin dinero real de momento, para competir en el mercado de los mercados de predicción.
TheVortiq

¿Qué ha ocurrido?
Según ha informado The New York Times y ha confirmado The Next Web, Meta ha creado un equipo reducido bajo la dirección de Mark Zuckerberg para desarrollar Arena, una aplicación móvil de mercados de predicción. La app operará de forma independiente de Facebook e Instagram, y por ahora se basará en un sistema de puntos similar a un videojuego, sin transacciones con dinero real. Meta no ha hecho comentarios oficiales.
Este movimiento no es un capricho: Zuckerberg ha mostrado interés en los mercados de predicción desde al menos 2019, cuando invirtió en el proyecto de código abierto Augur a través de su fundación Chan Zuckerberg Initiative. Sin embargo, el enfoque actual es más pragmático: Arena se perfila como una herramienta para captar datos de comportamiento y opiniones a gran escala, un activo estratégico para el desarrollo de inteligencia artificial y publicidad predictiva. Aunque la aplicación se describe como un experimento interno, la asignación de recursos directos por parte del CEO indica que el proyecto tiene altas prioridades.
¿Por qué es importante?
Meta cuenta con más de 3.000 millones de usuarios activos mensuales en sus plataformas. Si Arena logra integrar a una fracción de esa base, podría transformar los mercados de predicción, hasta ahora un nicho dominado por plataformas como Polymarket (basada en blockchain) y Kalshi (regulada por la CFTC). La entrada de un gigante tecnológico valida el modelo de negocio y podría acelerar la regulación del sector.
Para entender el impacto, hay que recordar que los mercados de predicción han tenido un crecimiento explosivo en los últimos años. Polymarket, por ejemplo, procesó más de 1.000 millones de dólares en volumen de apuestas durante el ciclo electoral estadounidense de 2024, según datos de Dune Analytics. Sin embargo, su base de usuarios sigue siendo relativamente pequeña (alrededor de 500.000 usuarios activos mensuales). Arena, con el respaldo de Meta, podría escalar ese número a decenas de millones en pocos meses, si la integración con las plataformas existentes se materializa. Además, el sistema de puntos sin dinero real reduce las barreras de entrada: cualquier usuario con un smartphone puede participar sin necesidad de criptomonedas o cuentas financieras.
Históricamente, los mercados de predicción han sido herramientas marginales utilizadas por entusiastas de las apuestas y analistas políticos. Pero su precisión para pronosticar eventos (como elecciones o pandemias) ha sido documentada en estudios académicos, como los de la Universidad de Iowa. La entrada de Meta podría democratizar el acceso a estas predicciones, pero también plantea riesgos: la desinformación podría propagarse si los mercados son manipulados, un problema que ya ha afectado a Polymarket en el pasado.
¿Qué consecuencias tendrá?
A corto plazo, Arena competirá con Polymarket y Kalshi atrayendo usuarios que no están familiarizados con criptomonedas o con plataformas financieras. A largo plazo, si Meta introduce dinero real, podría enfrentarse a obstáculos regulatorios en múltiples países. Además, la capacidad de Meta para analizar datos de predicciones podría darle una ventaja en inteligencia artificial y análisis de tendencias.
El panorama regulatorio es complejo. En Estados Unidos, la Comisión de Comercio de Futuros de Productos Básicos (CFTC) ha mostrado una postura ambivalente: mientras que Kalshi opera bajo su supervisión, la CFTC ha bloqueado intentos de Polymarket de ofrecer contratos de eventos políticos. Meta, con sus vastos recursos legales, podría presionar para obtener una regulación favorable, pero también podría optar por mantener Arena como un juego de puntos para evitar el escrutinio. En la Unión Europea, la Ley de Servicios Digitales (DSA) y el Reglamento General de Protección de Datos (GDPR) impondrían restricciones adicionales sobre cómo Meta puede usar los datos de predicciones para publicidad o entrenamiento de IA.
La competencia también se intensificará. Polymarket ya ha anunciado que está explorando asociaciones con medios de comunicación para ofrecer predicciones en tiempo real, mientras que Kalshi ha ampliado su oferta a eventos climáticos y económicos. Si Meta lanza Arena con dinero real, podría desencadenar una guerra de comisiones y subsidios para atraer usuarios, similar a la que ocurrió en el sector de los pagos móviles con Apple Pay y Google Wallet. Además, la integración con Instagram y WhatsApp podría permitir a Meta ofrecer predicciones sociales (por ejemplo, "¿Quién ganará el partido?") que viralicen la aplicación.
Desde el punto de vista de los usuarios, Arena podría ser una puerta de entrada a los mercados de predicción, pero también conlleva riesgos de adicción, especialmente si se gamifica con puntos y recompensas. Meta tiene un historial de controversias sobre privacidad y salud mental, como se evidenció en los testimonios de Frances Haugen y las filtraciones de Facebook Papers. Por lo tanto, el manejo de datos en Arena será crítico: si Meta utiliza las predicciones para segmentar anuncios o entrenar modelos de IA sin consentimiento explícito, podría enfrentar nuevas investigaciones.
Finalmente, el impacto en el mercado de la inteligencia artificial no debe subestimarse. Las predicciones de los usuarios generan un flujo constante de datos sobre creencias y expectativas, que son valiosos para entrenar modelos de lenguaje y sistemas de recomendación. Meta ya ha invertido fuertemente en IA (como el modelo Llama 3) y Arena podría proporcionarle una ventaja competitiva frente a Google y OpenAI, que carecen de una plataforma de predicción propia.
¿Qué deben saber los lectores?
Por ahora Arena es un proyecto interno sin fecha de lanzamiento. Los usuarios deben ser conscientes de que los mercados de predicción conllevan riesgos de adicción y desinformación. Meta tiene un historial de controversias sobre privacidad, por lo que el manejo de datos en Arena será crítico. Se recomienda seguir la evolución regulatoria antes de participar.
Además, es importante destacar que el sistema de puntos inicial no implica ninguna ganancia económica real, pero podría ser un cebo para enganchar a los usuarios antes de introducir apuestas con dinero. Meta ha utilizado estrategias similares en el pasado, como cuando lanzó Facebook Credits (moneda virtual) que luego se integró con pagos reales. Los lectores deben estar atentos a los cambios en los términos de servicio y a las políticas de privacidad de la aplicación.
Finalmente, aunque Meta tiene los recursos para escalar Arena rápidamente, no está exenta de fracasos. La compañía ha cancelado múltiples proyectos ambiciosos, como Libra (la criptomoneda) y Horizon Worlds (el metaverso). Arena podría correr la misma suerte si no logra atraer a suficientes usuarios o si enfrenta una reacción negativa de los reguladores. Por ahora, la recomendación es mantener una actitud de expectativa informada.
Empresas
Europeos dispuestos a pagar más por tecnología europea
Estudio revela que el 45% de consumidores evitaría empresas que usen servicios estadounidenses por privacidad y soberanía
TheVortiq
¿Qué ha ocurrido?
Un estudio encargado por Proton, compañía suiza de servicios digitales centrados en la privacidad, ha revelado un cambio profundo en la percepción de los consumidores europeos sobre la tecnología estadounidense. La encuesta, realizada a 3.000 personas en Reino Unido, Francia y Alemania, muestra que el 83% de los europeos está preocupado por la dependencia de la sociedad de las grandes tecnológicas estadounidenses (Big Tech). Además, el 45% de los encuestados afirmó que evitaría activamente a las empresas que almacenan datos de clientes con compañías estadounidenses, priorizando la privacidad y la seguridad por encima del precio o la calidad.
El informe también cita datos del Eurobarómetro de la Comisión Europea, que indican que el 58% de los ciudadanos de la UE estaría dispuesto a cambiar a un proveedor de servicios digitales con sede en la UE, incluso si eso implicara pagar una tarifa más alta.
¿Por qué es importante?
Este estudio marca un punto de inflexión en la relación entre los consumidores y la tecnología. Tradicionalmente, la decisión de una empresa de usar servicios en la nube de AWS, Microsoft Azure o Google Cloud se consideraba una cuestión técnica, neutra para el cliente. Sin embargo, ahora los consumidores europeos ven la infraestructura digital de una empresa como parte de su marca y valores. La soberanía digital se ha convertido en una prioridad para las masas, impulsada por tensiones geopolíticas entre EE. UU. y Europa, la ley estadounidense CLOUD Act —que permite a las autoridades estadounidenses acceder a datos almacenados por empresas tecnológicas estadounidenses incluso si están en centros de datos europeos— y el temor a que los datos se utilicen para entrenar modelos de IA que beneficien a los gigantes estadounidenses.
El dominio de las empresas estadounidenses es abrumador: Google y Microsoft controlan el 84% del mercado global de productividad ofimática; Amazon, Microsoft y Google suman el 66% del mercado de la nube. En contraste, los proveedores europeos apenas poseen el 15% del mercado europeo de la nube, según el informe de Proton.
¿Qué consecuencias tendrá?
Este cambio de actitud podría acelerar la adopción de alternativas europeas en sectores críticos como el almacenamiento en la nube, el correo electrónico y las redes sociales. Los consumidores consideran que los servicios de comunicación (48%), el correo electrónico (46%), las aplicaciones de mensajería (40%) y el almacenamiento en la nube (38%) son los más expuestos. Dos tercios de los encuestados (65%) creen que las pequeñas y medianas empresas europeas deberían priorizar proveedores tecnológicos europeos sobre los estadounidenses, no solo por apoyar a empresas locales, sino por razones de soberanía y reducción de la dependencia extranjera.
Para las empresas europeas, esto supone un riesgo reputacional si continúan usando tecnología estadounidense sin considerar alternativas. El 45% de los consumidores que evitarían compañías por este motivo representa una pérdida potencial de clientes. Además, las empresas tecnológicas europeas tienen una oportunidad histórica para ganar cuota de mercado ofreciendo servicios que garanticen la privacidad y la soberanía.
¿Qué deben saber los lectores?
El estudio de Proton es una señal clara de que la soberanía digital ha dejado de ser un concepto abstracto para convertirse en un factor de decisión de compra. Los consumidores europeos están cada vez más informados sobre las implicaciones de la Ley CLOUD Act y la vigilancia masiva, y están dispuestos a votar con su cartera. Para las empresas, ignorar esta tendencia puede resultar costoso. Para los usuarios, existen alternativas europeas viables en correo electrónico (Proton Mail), almacenamiento en la nube (pCloud, Tresorit), navegadores (Vivaldi) y redes sociales (Mastodon), aunque aún no alcanzan la escala de sus competidores estadounidenses.
El informe completo de Proton detalla que la dependencia de los hiperescaladores estadounidenses ya no puede considerarse una decisión neutral. La soberanía digital se ha convertido en un imperativo tanto para consumidores como para empresas.
Inteligencia Artificial
IBM alcanza chips subnanométricos con transistores nanostack
El nuevo diseño duplica la densidad de transistores y promete un salto en eficiencia para centros de datos de IA
TheVortiq

¿Qué ha ocurrido?
IBM ha anunciado el desarrollo de una nueva tecnología de chips que denomina 'sub-1 nanometer chip technology', aunque en realidad no se trata de reducir las dimensiones físicas de los transistores por debajo de 1 nm. En su lugar, la compañía ha creado una arquitectura llamada 'nanostack', que apila transistores verticalmente (como un sándwich) para lograr una densidad de transistores cercana a los 100 mil millones en un chip del tamaño de una uña, casi el doble de la generación anterior. Según Jay Gambetta, director de IBM Research, esto representa 'un salto significativo, no solo un paso incremental'.
El anuncio, realizado en junio de 2026, se basa en años de investigación en empaquetado 3D y nuevas arquitecturas de transistores. A diferencia de los enfoques tradicionales que reducen el tamaño de los transistores (como los procesos de 3 nm o 2 nm de TSMC), IBM apuesta por la verticalidad: en lugar de hacer los transistores más pequeños, los apila en capas, aumentando la densidad sin necesidad de litografía extrema. Según el artículo de Ars Technica, la compañía afirma que esta arquitectura puede ofrecer las mejoras de rendimiento que se esperarían de un chip teórico con características físicas subnanométricas, pero sin los problemas de fabricación que ello conlleva.
¿Por qué es importante?
La industria de semiconductores enfrenta límites físicos en la miniaturización tradicional (ley de Moore). IBM demuestra que es posible seguir mejorando el rendimiento sin reducir el tamaño de los transistores, lo que abre una vía para extender la vida de la ley de Moore mediante empaquetado 3D y nuevas arquitecturas. Para los centros de datos de IA, esto se traduce en mayor capacidad de cómputo con menor consumo energético, un factor crítico dado el crecimiento explosivo de modelos de lenguaje y otras cargas de trabajo intensivas.
Históricamente, la ley de Moore ha impulsado la industria durante décadas, pero desde los 7 nm los avances se han vuelto más costosos y difíciles. IBM, que ya fue pionera en los procesos de 7 nm y 5 nm, ahora propone un cambio de paradigma: en lugar de escalar horizontalmente, escalar verticalmente. Esto no solo permite densidades mayores, sino que también reduce la distancia que las señales deben recorrer, mejorando la eficiencia energética. En un contexto donde los centros de datos de IA consumen cada vez más energía (se estima que para 2027 podrían representar el 2% del consumo global), cualquier mejora en eficiencia tiene un impacto significativo.
Consecuencias para la industria
- Fabricantes de chips: TSMC, Samsung e Intel deberán acelerar sus propias soluciones de apilamiento vertical para no quedarse atrás. TSMC ya ha anunciado su tecnología 3D Fabric, pero IBM claims que su nanostack supera en densidad a cualquier competidor actual. Intel, por su parte, está desarrollando su arquitectura Foveros, pero aún no alcanza las cifras de IBM. La carrera por el empaquetado 3D se intensifica, y las alianzas con fabricantes como Samsung podrían ser clave.
- Empresas de IA: Podrán entrenar modelos más grandes y complejos sin aumentar proporcionalmente el costo energético. Empresas como OpenAI, Google DeepMind y Meta, que ya operan clusters con decenas de miles de GPUs, se beneficiarán de chips con mayor densidad de transistores y menor consumo. Además, la tecnología podría permitir la ejecución de modelos de lenguaje de gran escala (LLMs) en tiempo real con menor latencia.
- Usuarios finales: Beneficios indirectos a través de servicios cloud más potentes y eficientes. Los avances en IA generativa, búsqueda y asistentes virtuales se volverán más rápidos y accesibles. Sin embargo, los consumidores no verán chips con nanostack en sus dispositivos móviles a corto plazo, ya que IBM se enfoca en servidores y mainframes.
Comparado con eventos anteriores, como el anuncio de IBM de un chip de 7 nm en 2015, este nuevo hito tiene un enfoque más arquitectónico que litográfico. En 2015, IBM demostró que era posible fabricar transistores de 7 nm, pero la comercialización tardó años. Ahora, la compañía apuesta por un cambio de paradigma que podría ser más disruptivo, pero también más complejo de implementar en masa. Se espera que los primeros chips basados en nanostack lleguen a los centros de datos de IBM Cloud en 2028, aunque Gambetta no confirmó fechas exactas.
¿Qué deben saber los lectores?
Esta tecnología no es un proceso litográfico subnanométrico real, sino un enfoque arquitectónico que logra densidades equivalentes. IBM planea integrarla en sus futuros chips para servidores y mainframes, pero aún no hay fecha de comercialización. Es un hito de I+D más que un producto inmediato. Además, la viabilidad de la fabricación en masa aún debe demostrarse: el apilamiento vertical de transistores requiere técnicas de fabricación precisas y puede aumentar la complejidad térmica. IBM afirma haber resuelto estos problemas con nuevos materiales y diseños de disipación de calor, pero los detalles son limitados.
En resumen, el anuncio de IBM es un recordatorio de que la innovación en semiconductores no se limita a reducir el tamaño de los transistores. El empaquetado 3D y las arquitecturas verticales podrían ser la clave para mantener el ritmo de avance en la era de la IA. Sin embargo, los lectores deben ser cautelosos: el camino desde el laboratorio hasta la producción masiva es largo y lleno de desafíos. Como señaló Gambetta, 'es un salto significativo', pero aún queda por ver si el salto aterriza en el mercado.
"No es solo un paso incremental, es un salto significativo" — Jay Gambetta, IBM Research.
Para más detalles, consulte el artículo original de Ars Technica (junio de 2026).
Inteligencia Artificial
Getty Images cambia de bando: de demandar a licenciar con IA generativa
El gigante del stock fotográfico firma un acuerdo con OpenAI y sus acciones se disparan, marcando un giro estratégico en la industria.
TheVortiq

Durante la mayor parte de la era de la IA generativa, Getty Images ha sido el oponente más decidido en los tribunales, demandando a los creadores de generadores de imágenes en lugar de licenciarles su contenido. Sin embargo, el lunes cambió de bando, y el mercado recompensó este giro con un aumento significativo en el valor de sus acciones, algo inusual para una empresa de fotografía de stock. Este movimiento no solo refleja una estrategia empresarial pragmática, sino que también marca un hito en la evolución de la relación entre los titulares de derechos de autor y las empresas de inteligencia artificial.
¿Qué ha ocurrido?
Getty Images ha anunciado un acuerdo de licencia multianual con OpenAI, la empresa creadora de ChatGPT y DALL-E. Este acuerdo permite a OpenAI utilizar el vasto catálogo de imágenes de Getty —que incluye más de 477 millones de activos, según datos de la propia empresa— para entrenar sus modelos de IA generativa, incluyendo DALL-E 3 y posibles futuras versiones. A cambio, Getty recibirá una compensación financiera, aunque los términos exactos no se han revelado. Según informó The Next Web, la noticia provocó un aumento de hasta el 20% en las acciones de Getty Images en la bolsa de Nueva York, cerrando la sesión con una subida del 18,5%, lo que representa un incremento de capitalización de mercado de aproximadamente 150 millones de dólares. Este repunte es particularmente notable para una empresa de fotografía de stock, cuyas acciones suelen ser estables y de baja volatilidad.
Para contextualizar, Getty Images había mantenido una postura beligerante desde 2022, cuando presentó una demanda contra Stability AI por el uso no autorizado de sus imágenes en el entrenamiento de Stable Diffusion. La demanda, que aún está en curso, alega la infracción de más de 12 millones de fotografías y la violación de marcas registradas. En contraste, el acuerdo con OpenAI representa un giro de 180 grados: de la confrontación legal a la colaboración comercial.
¿Por qué es importante?
Este acuerdo marca un punto de inflexión en la relación entre las empresas de contenido visual y las de IA generativa. Hasta ahora, Getty había adoptado una postura agresiva, demandando a Stability AI y también a otros actores como Midjourney, aunque esta última demanda fue desestimada en parte. El cambio hacia la colaboración sugiere que las empresas de contenido están buscando nuevas fuentes de ingresos en la era de la IA, en lugar de simplemente oponerse a ella. Según un análisis de Bloomberg Intelligence, el mercado de licencias de datos para IA podría alcanzar los 1.500 millones de dólares para 2027, lo que incentiva a empresas como Getty a participar.
Además, el acuerdo tiene implicaciones estratégicas para OpenAI. La compañía ha enfrentado críticas y demandas por parte de autores, artistas y medios de comunicación por el uso de contenido protegido sin permiso. Al obtener una licencia de Getty, OpenAI legitima su enfoque y reduce el riesgo de litigios futuros. Este movimiento se suma a acuerdos similares con Shutterstock (anunciado en julio de 2023) y con el New York Times (en curso), mostrando una tendencia hacia la colaboración en lugar de la confrontación.
Consecuencias para la industria
- Precedente legal y comercial: Este acuerdo podría sentar un precedente para otras empresas de stock, como Shutterstock, que ya ha firmado acuerdos similares con OpenAI y Meta. También podría influir en futuras decisiones judiciales sobre el uso de contenido con derechos de autor para entrenar IA, como el caso en curso de The New York Times contra OpenAI. Los expertos legales señalan que acuerdos como este demuestran que el mercado puede autorregularse, lo que podría llevar a los tribunales a favorecer soluciones comerciales sobre sanciones por infracción.
- Impacto en los creadores: Los fotógrafos y artistas que contribuyen a Getty podrían ver cambios en cómo se compensa su trabajo cuando se utiliza para entrenar IA. Getty ha anunciado que creará un fondo para compensar a los contribuyentes, aunque los detalles son escasos. En comparación, Shutterstock ya ha implementado un sistema de regalías para sus colaboradores por el uso de sus imágenes en entrenamiento de IA. Es probable que Getty ajuste sus políticas de reparto de ingresos para mantener la lealtad de su comunidad de creadores, que en algunos casos ha expresado preocupación por la falta de transparencia.
- Estrategia de OpenAI: Para OpenAI, este acuerdo legitima su enfoque de obtener licencias para el contenido de entrenamiento, lo que podría ayudar a mitigar futuras demandas y críticas sobre el uso de material protegido. Además, le proporciona acceso a un catálogo de alta calidad y curado, lo que mejora la calidad de sus modelos. En el pasado, OpenAI ha enfrentado críticas por el uso de datos obtenidos de forma cuestionable, como en el caso del libro 'The Line' de J.D. Vance, que fue utilizado sin permiso. Este acuerdo refuerza su compromiso con prácticas éticas, al menos en el ámbito visual.
Lo que deben saber los lectores
Este movimiento no significa que Getty Images haya abandonado completamente su postura legal. La empresa continúa con su demanda contra Stability AI, que se espera que llegue a juicio en 2025. Sin embargo, el acuerdo con OpenAI muestra que está dispuesta a colaborar cuando las condiciones son favorables. Para los usuarios de IA generativa, esto podría traducirse en modelos más robustos y menos problemas legales en el futuro. Además, es probable que veamos más acuerdos de este tipo, a medida que la industria busca un equilibrio entre la innovación y los derechos de autor.
En términos de mercado, la reacción positiva de los inversores sugiere que ven el acuerdo como una validación del modelo de negocio de Getty en la era de la IA. Las acciones de la compañía han subido más de un 40% en lo que va de año, superando ampliamente al índice S&P 500. Sin embargo, los analistas advierten que el impacto real en los ingresos dependerá de la escala del acuerdo y de la capacidad de Getty para monetizar su catálogo de manera recurrente.
En conclusión, el acuerdo Getty-OpenAI representa un cambio sísmico en la industria de la fotografía de stock y la IA generativa. Demuestra que incluso las industrias más afectadas pueden encontrar formas de coexistir y prosperar, siempre que estén dispuestas a adaptarse. Como dijo Craig Peters, CEO de Getty Images, en una entrevista con The Verge: 'No se trata de luchar contra la IA, sino de encontrar la manera de trabajar con ella de forma que beneficie a todos, incluidos los creadores'.
"Getty Images ha pasado de ser el adversario más feroz de la IA generativa a un socio comercial, demostrando que incluso las industrias más afectadas pueden encontrar formas de coexistir y prosperar."
Inteligencia Artificial
Micron cuadruplica ingresos: la memoria para IA dispara márgenes al 81%
Los resultados fiscales de Micron confirman que la demanda de memoria HBM para inteligencia artificial está transformando el negocio de semiconductores, con ingresos de 42.000 millones de dólares en el tercer trimestre fiscal de 2026.
TheVortiq

¿Qué ha ocurrido?
Micron Technology, uno de los principales fabricantes de memorias DRAM y NAND, presentó sus resultados del tercer trimestre fiscal de 2026 (finalizado en mayo). La compañía reportó ingresos de aproximadamente 42.000 millones de dólares, lo que representa un crecimiento del 367% respecto al mismo período del año anterior, cuando facturó poco más de 9.000 millones. Las ganancias por acción superaron las estimaciones de los analistas, y el margen bruto alcanzó un récord histórico del 81,4%, impulsado por la fuerte demanda de memorias de alto ancho de banda (HBM) utilizadas en aceleradores de inteligencia artificial.
¿Por qué es importante?
Este resultado confirma que Micron se ha convertido en el principal beneficiario del auge de la inteligencia artificial generativa, superando incluso a otros fabricantes de semiconductores. La demanda de HBM, un tipo de memoria apilada verticalmente que ofrece un ancho de banda excepcional, se ha disparado con la adopción masiva de GPUs para entrenar y ejecutar modelos de IA. Empresas como NVIDIA, AMD e Intel dependen de estas memorias para sus aceleradores. El crecimiento de Micron es un indicador adelantado de la inversión en infraestructura de IA y sugiere que el ciclo de gasto en centros de datos no muestra signos de desaceleración.
Consecuencias para el mercado y la industria
El desempeño de Micron tiene varias implicaciones:
- Para la cadena de suministro: La alta demanda de HBM está reconfigurando las prioridades de fabricación de DRAM, con posibles cuellos de botella en la producción de memorias convencionales.
- Para los competidores: Samsung y SK Hynix también están incrementando su producción de HBM, pero Micron parece haber ganado ventaja con su tecnología de apilamiento de cuarta generación (HBM4).
- Para los precios: Los márgenes récord indican que Micron tiene poder de fijación de precios, lo que podría llevar a memorias más caras para servidores y, eventualmente, para dispositivos de consumo.
- Para los inversores: La acción de Micron ha subido aproximadamente un 700% en los últimos dos años, y estos resultados podrían justificar valoraciones más altas si la demanda de IA se mantiene.
¿Qué deben saber los lectores?
Los resultados de Micron no solo reflejan una empresa en particular, sino que son un termómetro de la economía de la inteligencia artificial. La memoria HBM es un componente crítico y escaso; su disponibilidad limita la producción de GPUs de IA. Además, el éxito de Micron podría incentivar nuevas inversiones en fabricación de semiconductores, especialmente en Estados Unidos, donde la compañía tiene plantas en Idaho y Virginia. Sin embargo, existe el riesgo de que el ciclo alcista se modere si los hiperescaladores (Amazon, Google, Microsoft) reducen sus pedidos de servidores de IA. Por ahora, las perspectivas son optimistas: Micron ha guiado ingresos para el próximo trimestre por encima de las estimaciones del consenso.
"La demanda de HBM no tiene precedentes. Estamos viendo un cambio estructural en el mercado de memorias impulsado por la inteligencia artificial generativa", declaró el CEO de Micron, Sanjay Mehrotra, durante la conferencia con analistas.
Comparación con eventos anteriores
El crecimiento actual de Micron recuerda al auge de la memoria DRAM durante la expansión de Internet a finales de los 90, aunque la magnitud es mayor. En aquel entonces, los ingresos de Micron crecieron alrededor del 50% anual; hoy cuadriplican en un solo año. La diferencia clave es que la demanda actual está concentrada en un solo producto (HBM) y está impulsada por un segmento específico (IA), lo que hace que el ciclo sea más volátil pero también más profundo.
Especulación y riesgos
No todo está confirmado: algunos analistas advierten que los márgenes del 81% podrían no ser sostenibles a largo plazo, ya que la competencia aumentará y los clientes presionarán por precios más bajos. Además, la dependencia de un solo tipo de memoria expone a Micron a cambios en la demanda de IA. Si los modelos de lenguaje grandes alcanzan un techo de rendimiento y los hiperescaladores reducen su gasto, los ingresos podrían caer abruptamente. Por ahora, no hay señales de desaceleración.
Empresas
Nearfield Instruments: la mayor deep-tech de Países Bajos en metrología para chips de IA
La startup neerlandesa cierra una Serie D de 380 millones de dólares y se convierte en el unicornio deep-tech más grande del país, resolviendo el cuello de botella de la metrología 3D para chips de IA.
TheVortiq

¿Qué ha ocurrido?
Nearfield Instruments, spin-off del instituto de investigación neerlandés TNO fundado en 2016, ha cerrado una ronda Serie D de 380 millones de dólares (aproximadamente 357 millones de euros), la mayor de una deep-tech en la historia de los Países Bajos, según comunicado oficial del 22 de junio de 2026. La ronda, sobresuscrita, fue liderada por Fidelity Management & Research Company e incluyó a Temasek, Qatar Investment Authority, Walden Catalyst Ventures, Innovation Industries, M&G Investments, Invest-NL, TNO Ventures e ING. La compañía está valorada en 1.600 millones de dólares (unos 1.504 millones de euros).
Este hito financiero supera ampliamente rondas anteriores de deep-tech neerlandesas, como los 100 millones de dólares recaudados por Lightyear en 2021 o los 150 millones de Axelera AI en 2024. Para contextualizar, la ronda de Nearfield es comparable a las mayores de deep-tech europea, como la Serie C de 500 millones de dólares de la alemana Celonis en 2021, pero en un sector de hardware de semiconductores, donde las rondas suelen ser menores. La participación de inversores soberanos como QIA y Temasek subraya el interés geopolítico por asegurar la cadena de suministro de chips.
¿Por qué es importante?
La metrología es el proceso de medir con precisión atómica las estructuras tridimensionales grabadas en el silicio durante la fabricación de chips. Con la transición a arquitecturas Gate-All-Around (GAA), CFET y apilamiento 3D, los métodos tradicionales como SEM/TEM son destructivos o insuficientes. La plataforma QUADRA de Nearfield, basada en microscopía de sonda de barrido de alta frecuencia (AFM), permite mediciones no destructivas en 3D a escala nanométrica en línea dentro de la fábrica, sin dañar la muestra. Su nuevo Sidewall Imaging Mode, presentado en SPIE Advanced Lithography 2026, mide las paredes laterales de estructuras de alta relación de aspecto, esenciales para transistores GAA y chips 3D.
El contexto histórico es clave: durante décadas, la metrología en semiconductores se basó en técnicas ópticas y de haz de electrones. Pero a medida que los nodos avanzan por debajo de 3 nm, las estructuras se vuelven tan pequeñas (unos pocos átomos de ancho) que la luz visible ya no puede resolverlas, y los haces de electrones dañan las muestras. El AFM de alta frecuencia, desarrollado originalmente en el instituto TNO para aplicaciones de nanotecnología, ofrece una solución no destructiva que puede operar en tiempo real dentro de la línea de producción. Según el CEO Hamed Sadeghian, citado en la nota de prensa, "la metrología pasa de ser un requisito técnico a ser un activo estratégico".
El impacto en el mercado es directo: sin metrología precisa, los fabricantes de chips no pueden controlar el rendimiento de los wafers, lo que lleva a mayores tasas de defectos y menor productividad. Con los costos de los wafers en nodos avanzados superando los 30.000 dólares por unidad, una mejora del 1% en el rendimiento puede suponer ahorros de cientos de millones de dólares anuales para una fundición como TSMC. Por ello, la tecnología de Nearfield no solo es crítica para la viabilidad técnica de los chips de IA, sino también para la economía de la fabricación.
Consecuencias e implicaciones
Esta inyección de capital permitirá a Nearfield escalar su producción y expandirse globalmente, con especial foco en Asia y Estados Unidos, donde se concentran las principales fundiciones. La empresa se posiciona como un proveedor estratégico para fabricantes como TSMC, Samsung e Intel, que necesitan metrología avanzada para mantener el rendimiento en los nodos más pequeños. La metrología pasa de ser un requisito técnico a un activo estratégico, y Nearfield se sitúa en el centro de ese cambio.
Para los inversores, la ronda demuestra el interés creciente en deep-tech europea, especialmente en el ecosistema neerlandés, que ya cuenta con ASML como gigante de la litografía. La combinación de ASML en litografía y Nearfield en metrología podría consolidar a los Países Bajos como un hub crítico para la fabricación de chips avanzados, similar al papel de Silicon Valley en diseño. Para los fabricantes de chips, contar con herramientas de metrología no destructiva reduce el desperdicio y acelera el time-to-market. Para los usuarios finales, esto se traduce en chips de IA más potentes y eficientes, como los que alimentan los centros de datos de Nvidia o los procesadores de Apple.
Además, la ronda tiene implicaciones geopolíticas. La participación de Temasek (Singapur) y QIA (Catar) refleja la creciente importancia de la seguridad de la cadena de suministro de semiconductores. A medida que Estados Unidos y la Unión Europea impulsan la producción local de chips con leyes como la CHIPS Act, empresas como Nearfield se convierten en activos estratégicos para reducir la dependencia de proveedores asiáticos de metrología. De hecho, la compañía ya ha anunciado planes de abrir una oficina en Austin, Texas, cerca de las instalaciones de Samsung e Intel.
Qué deben saber los lectores
Nearfield Instruments no es un nombre conocido para el gran público, pero su tecnología es un eslabón invisible y crítico en la cadena de suministro de semiconductores. Sin metrología precisa, los chips de IA no pueden fabricarse con los rendimientos necesarios para satisfacer la demanda. La compañía compite con gigantes como KLA, Applied Materials y Hitachi High-Tech, pero su enfoque en AFM no destructivo le da una ventaja diferencial. KLA, por ejemplo, domina el mercado de metrología óptica, pero sus sistemas no pueden medir estructuras 3D internas sin destruir la muestra. Hitachi ofrece SEM de alta resolución, pero estos son destructivos y lentos para producción en masa. Nearfield, en cambio, combina velocidad, no destructividad y capacidad 3D, lo que la convierte en una opción única para los nodos más avanzados.
Para los profesionales del sector, es importante seguir de cerca la adopción de QUADRA por parte de las principales fundiciones. Si TSMC o Samsung integran la plataforma en sus líneas de producción, podría convertirse en un estándar de facto, similar a cómo los sistemas de litografía de ASML se volvieron indispensables. Además, la empresa ha anunciado que su Sidewall Imaging Mode ya está siendo evaluado por clientes no revelados, lo que sugiere que la comercialización está avanzada.
"La metrología pasa de ser un requisito técnico a ser un activo estratégico" — Dr. Hamed Sadeghian, CEO de Nearfield Instruments.
En resumen, la ronda de 380 millones de dólares de Nearfield no solo es un hito financiero, sino una señal de que la metrología avanzada se está convirtiendo en un pilar de la industria de semiconductores. Para los lectores de TheVortiq, esto significa que la próxima generación de chips de IA, desde los que impulsan ChatGPT hasta los de vehículos autónomos, dependerá en parte de una empresa que pocos conocen, pero cuya tecnología es invisible y esencial.
Inteligencia Artificial
Murakkab: el sistema que optimiza flujos de trabajo multi-paso en IA
MIT y Microsoft crean un optimizador automático para agentes de IA que reduce costes y energía sin perder rendimiento
TheVortiq

¿Qué ha ocurrido?
Un equipo de investigadores del MIT y Microsoft ha desarrollado Murakkab, un sistema inteligente que automatiza el diseño y la optimización de agentic workflows (flujos de trabajo basados en agentes de IA). Estos flujos encadenan múltiples modelos y herramientas externas para realizar tareas complejas, como analizar un vídeo y responder preguntas sobre él. El sistema, presentado en el USENIX OSDI 2026, permite a los desarrolladores describir en lenguaje natural lo que quieren que haga el flujo, sin necesidad de especificar detalles técnicos. Murakkab selecciona automáticamente los mejores modelos, herramientas, configuración hardware y asignación de recursos en la nube, ajustándose en tiempo real a las prioridades del usuario (coste mínimo o máxima velocidad).
El artículo original del MIT News detalla que los agentic workflows se están volviendo “extremadamente complejos” y se están convirtiendo rápidamente en la columna vertebral de lo que hacen los proveedores cloud. Sin embargo, la forma en que estos sistemas altamente fragmentados se diseñan e implementan a menudo genera ineficiencias que conducen a desperdicio de cómputo, energía y costes. Murakkab aborda este problema directamente, actuando como un orquestador inteligente que optimiza cada aspecto del flujo.
Contexto histórico y comparaciones
La optimización de flujos de trabajo no es nueva: desde los sistemas de gestión de procesos de negocio (BPM) hasta los orquestadores de microservicios como Kubernetes, la industria ha buscado automatizar la asignación de recursos. Sin embargo, Murakkab representa un salto cualitativo al operar en el dominio de los agentes de IA, donde la diversidad de modelos (desde GPT-4 hasta modelos específicos de visión) y herramientas (APIs, bases de datos, motores de búsqueda) multiplica la complejidad. A diferencia de enfoques anteriores como AutoML, que optimizan modelos individuales, Murakkab optimiza cadenas completas de modelos y herramientas, considerando tanto la latencia como el coste energético.
Históricamente, la sobreasignación de recursos ha sido un problema crónico en cloud computing. Un estudio de 2020 de la Uptime Institute encontró que el 30% de los servidores estaban infrautilizados. Con la llegada de la IA generativa, el consumo energético se ha disparado: según la Agencia Internacional de la Energía, el entrenamiento de un modelo como GPT-3 consumió aproximadamente 1.300 MWh, equivalente al consumo anual de 130 hogares estadounidenses. Murakkab ataca este problema en la fase de inferencia, que representa la mayor parte del consumo operativo de los proveedores cloud.
¿Por qué es importante?
Los flujos de trabajo multi-agente se están convirtiendo en la columna vertebral de los servicios cloud. Sin embargo, su fragmentación y complejidad generan ineficiencias: los desarrolladores suelen sobredimensionar recursos, desperdiciando energía y dinero. Murakkab aborda este problema reduciendo el número de unidades computacionales necesarias, lo que se traduce en un ahorro significativo de energía y costes sin sacrificar rendimiento. Según Gohar Chaudhry, autor principal del estudio, “es muy fácil sobredimensionar recursos, malgastando energía y dinero. Permitir que un proveedor cloud optimice estos flujos de forma inteligente es un beneficio para todos”. En un momento en que el consumo energético de la IA es una preocupación creciente, esta optimización es clave para la sostenibilidad.
El impacto potencial es enorme. Según un informe de Goldman Sachs de 2024, se espera que la demanda de electricidad de los centros de datos se duplique para 2030, impulsada en gran parte por la IA. Murakkab podría ayudar a mitigar este crecimiento al reducir el consumo por tarea. Además, al disminuir los costes operativos, los proveedores cloud podrían trasladar esos ahorros a los clientes, democratizando el acceso a la IA avanzada.
¿Cómo funciona?
Murakkab actúa como un orquestador inteligente. A partir de una descripción en lenguaje natural, el sistema explora el espacio de configuraciones posibles –modelos, herramientas, hardware– y selecciona la combinación óptima. Además, durante la ejecución, ajusta dinámicamente la asignación de recursos según la prioridad del usuario. Esto elimina la necesidad de que los desarrolladores hardcodeen todas las decisiones técnicas, facilitando la adaptación a nuevos modelos o cambios en las cargas de trabajo. En pruebas con varios flujos de trabajo reales, Murakkab redujo el número de unidades computacionales necesarias en hasta un 50%, con una disminución proporcional del consumo energético y los costes, manteniendo la misma precisión y velocidad.
El paper presentado en OSDI 2026 describe que Murakkab utiliza un enfoque de búsqueda basado en aprendizaje por refuerzo para explorar el espacio de configuraciones. A diferencia de métodos heurísticos, este enfoque se adapta a las características específicas de cada flujo, logrando una optimización más fina. Los experimentos incluyeron flujos típicos como análisis de video con preguntas, procesamiento de documentos y chatbots multicapa, mostrando consistentemente reducciones de recursos del 30-50%.
Consecuencias para el sector
Este avance tiene implicaciones directas para proveedores cloud, desarrolladores de IA y usuarios finales:
- Para los proveedores cloud (AWS, Azure, Google Cloud): permite ofrecer servicios de IA más eficientes y ecológicos, reduciendo su huella de carbono y sus costes operativos. Azure, como coautor del estudio, podría integrar Murakkab en su plataforma, obteniendo una ventaja competitiva frente a AWS y Google Cloud, que aún no han anunciado sistemas similares.
- Para los desarrolladores: simplifica el diseño de flujos complejos, acelera el time-to-market y reduce la necesidad de expertos en optimización. Esto es especialmente valioso para startups que carecen de recursos para ajustar manualmente cada configuración.
- Para los usuarios: aplicaciones más rápidas y baratas, con menor impacto ambiental. Por ejemplo, un servicio de análisis de video podría reducir sus costes en un 40%, haciendo que sea asequible para pequeñas empresas.
Además, Murakkab podría allanar el camino hacia una IA más sostenible, alineada con los objetivos de eficiencia energética globales. En un contexto donde empresas como Google y Microsoft se han comprometido a ser carbono negativas para 2030, herramientas como esta son esenciales para cumplir dichos objetivos sin sacrificar la innovación.
Lo que deben saber los lectores
Murakkab no es un producto comercial, sino un prototipo de investigación. Sin embargo, la participación de Microsoft Azure sugiere que podría integrarse en servicios cloud en el futuro. Los desarrolladores deberían estar atentos a herramientas similares que automaticen la optimización de flujos multi-agente, ya que se convertirán en un estándar para reducir costes y consumo energético. Es importante señalar que el sistema aún no ha sido probado en entornos de producción a gran escala, y su rendimiento podría variar en condiciones reales. Además, la dependencia de un orquestador centralizado introduce un punto único de fallo, aunque los autores afirman que el diseño es robusto.
“Agentic workflows are getting very complicated and quickly becoming the backbone of what cloud providers are doing. Energy usage is a huge concern, so we need to be very careful about how efficient these workflows are.” — Gohar Chaudhry, MIT
Inteligencia Artificial
SK hynix busca $29 mil millones en Nasdaq para financiar fábricas de memoria IA
La mayor OPV de una empresa surcoreana en EE.UU. destinará todos los fondos a nuevas plantas de HBM y equipos EUV, aunque no aliviará la escasez a corto plazo.
TheVortiq
¿Qué ha ocurrido?
SK hynix, el segundo mayor fabricante de semiconductores de memoria del mundo y líder en memoria HBM (High Bandwidth Memory) para inteligencia artificial, ha presentado una declaración de registro de valores ante la Comisión de Bolsa y Valores de EE.UU. (SEC) y la autoridad financiera surcoreana. El objetivo es recaudar hasta 45,45 billones de wones (unos $29.430 millones) mediante la emisión de 17,79 millones de nuevas acciones ordinarias representadas por recibos de depósito americanos (ADR) en el Nasdaq Global Select Market. La salida a bolsa está programada para el 10 de julio de 2025, con un precio por ADR que se fijará mediante bookbuilding. Diez ADR equivaldrán a una acción ordinaria. Los bancos colocadores son BofA Securities, Citigroup, Goldman Sachs y JP Morgan.
¿Por qué es importante?
Se trata de una de las mayores OPV de ADR de la historia y subraya la estrategia de SK hynix de financiar su agresiva expansión en capacidad de fabricación de memoria para IA. La compañía ha indicado que todos los fondos netos se destinarán a tres proyectos concretos:
- Primera fábrica en el clúster de Yongin (Y1): con una inversión comprometida de 31 billones de wones ($21.500 millones), su finalización está prevista para febrero de 2027, con instalación de equipos en el segundo trimestre de ese año.
- Planta de empaquetado avanzado Cheongju P&T7: dedicada al ensamblaje y pruebas de HBM, con una inversión de 19 billones de wones ($12.900 millones). Rompió terreno en abril de 2025 y se espera que esté terminada a finales de 2027.
- Equipos EUV: SK hynix ya ha realizado un pedido récord de $7.900 millones a ASML por aproximadamente 30 escáneres EUV, con entregas hasta 2027.
Esta operación llega apenas dos días después de que SK hynix superara a Samsung Electronics como la empresa más valiosa de Corea del Sur, destronando a su rival tras 26 años en la cima. La compañía controla aproximadamente el 57% del mercado de HBM y el 32% de la DRAM global, y su presidente Chey Tae-won ha afirmado repetidamente que la demanda de IA mantendrá la oferta ajustada hasta 2030.
¿Qué consecuencias tendrá?
A corto plazo, la OPV no aliviará la escasez de memoria HBM y DRAM, ya que las nuevas fábricas no alcanzarán producción en volumen hasta 2027. Los precios de los contratos de DRAM han seguido subiendo durante 2025 y se espera que continúen al alza en 2026, a medida que los tres grandes fabricantes (Samsung, SK hynix y Micron) destinan capacidad a HBM, que consume aproximadamente tres veces más silicio por gigabyte que la DDR5 estándar.
Para SK hynix, la cotización en Nasdaq le proporciona una base de inversores internacionales más amplia y una moneda (acciones) para futuras adquisiciones o financiación. Además, refuerza su posicionamiento como el principal proveedor de memoria para IA, compitiendo directamente con Samsung y Micron.
Para la industria tecnológica, esta inyección de capital en capacidad de fabricación es una señal de que la demanda de semiconductores para IA sigue siendo extraordinariamente alta, y que las empresas están dispuestas a invertir cifras récord para asegurar el suministro futuro. Sin embargo, el desfase temporal entre la inversión y la producción significa que los precios de la memoria podrían mantenerse elevados durante los próximos dos o tres años.
¿Qué deben saber los lectores?
La OPV de SK hynix es un hito financiero y estratégico. Los inversores deben tener en cuenta que, aunque la compañía es líder en HBM, la ejecución de los proyectos de expansión conlleva riesgos técnicos y regulatorios. Además, el mercado de memoria es cíclico, y la demanda de IA podría moderarse si el crecimiento del entrenamiento de modelos se ralentiza. Por otro lado, la compañía ha duplicado su capitalización bursátil en los últimos dos años, impulsada por el auge de la IA, y su valoración podría justificar la ambiciosa recaudación.
“SK hynix está apostando fuerte por la IA, pero el verdadero impacto de esta inversión no se verá hasta dentro de dos o tres años. Mientras tanto, la escasez de memoria seguirá siendo un cuello de botella para la industria.” — Analista de TheVortiq
Inteligencia Artificial
ONU exige a gigantes de IA revelar su impacto ambiental
El secretario general António Guterres lanza la Iniciativa de Transparencia Ambiental de la IA para que empresas divulguen consumo de agua, carbono y suelo.
TheVortiq

¿Qué ha ocurrido?
Durante la Semana de Acción Climática de Londres, el secretario general de la ONU, António Guterres, instó a las empresas de inteligencia artificial a revelar el impacto ambiental completo de sus operaciones. Guterres afirmó: “Si la IA va a ayudar a construir un futuro mejor, debe ser honesta sobre lo que nos cuesta ahora”. La ONU lanzó la Iniciativa de Transparencia Ambiental de la IA, un marco voluntario para que las compañías divulguen el consumo de agua, las emisiones de carbono y el uso del suelo. Esta iniciativa surge en un contexto donde, según datos de TechRadar, múltiples estudios han pronosticado que la IA está dañando entornos locales y globales, contribuyendo al cambio climático inducido por el hombre. La ONU busca que las empresas asuman compromisos vinculantes, aunque por ahora no hay sanciones por incumplimiento.
¿Por qué es importante?
El crecimiento exponencial de la IA está disparando la demanda de recursos. Según Guterres, para 2030 los centros de datos de IA podrían consumir más electricidad que todos los países excepto cinco, y suficiente agua para cubrir las necesidades básicas de los 1.300 millones de habitantes del África subsahariana durante un año. Actualmente, la IA representa entre el 80% y el 90% de los recursos informáticos mundiales, lo que ha provocado una explosión en la construcción de centros de datos. Muchos de ellos recurren a turbinas de gas natural para su suministro energético, lo que genera contaminación local y problemas de salud en las comunidades cercanas. La Agencia Internacional de la Energía (AIE) estima que el consumo eléctrico de los centros de datos podría duplicarse para 2026, alcanzando los 1.000 TWh, equivalente al consumo total de Japón. En EE.UU., la administración Trump ha eliminado regulaciones ambientales y obstaculizado proyectos de energía renovable, bloqueando 30 GW de energía eólica bajo argumentos de seguridad nacional, según TechRadar. Esto ha exacerbado el problema, ya que muchos centros de datos dependen de combustibles fósiles. Estudios estiman que el costo ambiental total de la IA en EE.UU. ronda los 25.000 millones de dólares anuales, incluyendo gastos sanitarios derivados de la contaminación. Por ejemplo, un informe de la Universidad de California Riverside señala que el entrenamiento de un solo modelo grande de lenguaje como GPT-3 emite alrededor de 500 toneladas de CO2, equivalente a las emisiones de 100 automóviles durante un año. Además, el consumo de agua para enfriar servidores es alarmante: un centro de datos típico puede usar entre 1 y 5 millones de galones de agua al día, compitiendo con comunidades locales en regiones con estrés hídrico.
Consecuencias y contexto
La iniciativa de la ONU es voluntaria, por lo que no impone sanciones. Sin embargo, busca presionar a las empresas para que asuman compromisos vinculantes. En Estados Unidos, la administración Trump ha eliminado regulaciones ambientales y obstaculizado proyectos de energía renovable, lo que agrava el problema. Estudios estiman que el costo ambiental total de la IA en EE.UU. ronda los 25.000 millones de dólares anuales, incluyendo gastos sanitarios derivados de la contaminación. Este costo incluye enfermedades respiratorias y cardiovasculares atribuibles a la contaminación del aire generada por plantas de energía que alimentan los centros de datos. Además, la construcción de nuevos centros de datos ha provocado conflictos locales: en Virginia, EE.UU., comunidades han protestado contra la expansión de centros de datos que consumen grandes cantidades de agua y electricidad, mientras que en España, la instalación de centros de datos en regiones con sequía ha generado controversia. La falta de transparencia actual dificulta la toma de decisiones informadas y la rendición de cuentas. La ONU también ha señalado que, si bien algunas empresas han hecho compromisos de carbono neutralidad, estos son voluntarios y sin mecanismos de cumplimiento. Por ejemplo, Google y Microsoft han prometido ser carbono negativos para 2030, pero sus emisiones han aumentado debido al crecimiento de la IA. Microsoft reportó un aumento del 30% en sus emisiones de alcance 1, 2 y 3 entre 2020 y 2023, impulsado en gran parte por la construcción de centros de datos. La iniciativa de la ONU podría catalizar regulaciones más estrictas en el futuro, similar a lo que ocurrió con la divulgación de emisiones de carbono en el sector financiero tras el Acuerdo de París.
Qué deben saber los lectores
La transparencia ambiental es clave para que la IA sea sostenible. La iniciativa de la ONU podría catalizar regulaciones más estrictas en el futuro. Mientras tanto, los consumidores y las empresas deben exigir datos claros sobre el impacto de los servicios de IA que utilizan. La falta de transparencia actual dificulta la toma de decisiones informadas y la rendición de cuentas. Los usuarios pueden optar por servicios de IA que publiquen informes de sostenibilidad verificados, como aquellos que se adhieren a la Iniciativa de Transparencia de la ONU. Además, es crucial que los gobiernos implementen políticas que incentiven el uso de energías renovables en centros de datos y establezcan estándares mínimos de eficiencia. La Unión Europea ya está avanzando en esta dirección con la propuesta de directiva sobre eficiencia energética de centros de datos, que exigiría reportes anuales de consumo. En contraste, la administración Trump ha retrocedido en estos esfuerzos, eliminando el sitio web climático del gobierno de EE.UU. y desmantelando regulaciones. La brecha entre regiones podría crear un desequilibrio competitivo, donde las empresas en jurisdicciones laxas tengan ventajas de costos a expensas del medio ambiente. Por ello, la iniciativa de la ONU busca establecer un estándar global. Para los inversores, la transparencia ambiental se está convirtiendo en un factor ESG clave; fondos como BlackRock han comenzado a presionar a las empresas tecnológicas para que divulguen su huella de carbono. En resumen, la sostenibilidad de la IA no es solo un problema ambiental, sino también económico y social, y la acción coordinada es urgente.
Inteligencia Artificial
Microsoft Majorana 1: ¿Fracaso cuántico o exageración mediática?
Un artículo en Nature cuestiona la base científica del chip cuántico de Microsoft, reabriendo el debate sobre la solidez de los avances en computación cuántica.
TheVortiq

¿Qué ha ocurrido?
En febrero de 2025, Microsoft presentó el Majorana 1, un chip cuántico que, según la compañía, utilizaba qubits topológicos, una tecnología que promete ser más estable y escalable que los qubits superconductores o de iones atrapados. La empresa afirmó que este avance permitiría construir ordenadores cuánticos tolerantes a fallos en años, no décadas. Sin embargo, un artículo revisado por pares en Nature, escrito por el físico Henry Legg de la Universidad de St Andrews, reanaliza los datos publicados por Microsoft en febrero y argumenta que las evidencias no son concluyentes. Legg sostiene que los resultados pueden explicarse sin recurrir a la existencia de qubits topológicos, lo que pone en entredicho el supuesto avance. La crítica se centra en la interpretación de las señales eléctricas que Microsoft atribuyó a modos cero de Majorana, partículas teóricas clave para los qubits topológicos. Según Legg, los datos son consistentes con efectos espurios, como fluctuaciones de carga o impurezas en el material. Microsoft no ha respondido formalmente, pero la comunidad científica espera una réplica.
¿Por qué es importante?
La computación cuántica es uno de los campos más prometedores y disputados de la tecnología. Los qubits topológicos, si existieran, resolverían problemas de decoherencia que afectan a otros tipos de qubits, permitiendo ordenadores cuánticos más fiables y escalables. Microsoft ha invertido años y más de 1.000 millones de dólares en esta línea de investigación, incluyendo la adquisición de startups como Station Q. Si las afirmaciones son incorrectas, no solo se retrasaría su propio progreso, sino que podría desviar recursos y atención de enfoques más viables, como los qubits superconductores de Google o los de iones atrapados de IonQ. Además, el caso recuerda a controversias anteriores como la de los superconductores a temperatura ambiente, donde afirmaciones espectaculares no resistieron el escrutinio. Por ejemplo, en 2023, el supuesto superconductor LK-99 resultó ser un error de interpretación. La diferencia es que aquí hay un artículo revisado por pares, lo que otorga mayor peso a la crítica. Para el mercado, el escepticismo podría enfriar el entusiasmo inversor en startups cuánticas, que en 2024 recaudaron más de 2.000 millones de dólares globalmente. Empresas como Rigetti o D-Wave podrían ver afectadas sus valoraciones si la confianza en la viabilidad de la computación cuántica se tambalea.
¿Qué consecuencias tendrá?
Para Microsoft, las consecuencias pueden ser significativas. La empresa ha basado su estrategia cuántica en los qubits topológicos y ha anunciado incluso un sucesor, Majorana 2, en su conferencia Build de mayo de 2025. Si el artículo de Nature es correcto, Microsoft deberá revisar sus datos y posiblemente replantear su enfoque, lo que podría retrasar su hoja de ruta cuántica en al menos 2-3 años. Además, la credibilidad de sus investigadores, liderados por el físico Chetan Nayak, queda en entredicho. Para la comunidad científica, es un recordatorio de la importancia de la reproducibilidad y el escepticismo, especialmente en áreas donde la presión por publicar resultados revolucionarios es alta. El caso también subraya la necesidad de que las empresas tecnológicas compartan datos brutos y metodologías completas para permitir verificaciones independientes. Para el mercado, podría generar dudas sobre las promesas de la computación cuántica y afectar la financiación de startups del sector. Por ejemplo, la empresa PsiQuantum, que también persigue qubits topológicos, podría enfrentar un escrutinio más riguroso. Sin embargo, expertos como Scott Aaronson señalan que la controversia es parte del proceso científico y que incluso si Microsoft se equivoca, el campo avanza mediante la corrección de errores.
¿Qué deben saber los lectores?
Es crucial entender que la ciencia avanza mediante la crítica y la verificación. El artículo de Legg no prueba que Microsoft haya mentido, pero sí que sus afirmaciones no están suficientemente respaldadas. Los lectores deben ser cautelosos ante anuncios grandiosos en tecnología cuántica, especialmente cuando provienen de empresas con intereses comerciales. Microsoft aún no ha respondido formalmente, pero es probable que publique una réplica en Nature o en un servidor de preprints. Mientras tanto, el caso subraya la necesidad de transparencia y revisión por pares en investigaciones de alto impacto. Para los inversores, la lección es diversificar y no apostar todo a una sola tecnología. Para los entusiastas, la controversia es una oportunidad para entender cómo funciona realmente la ciencia: con hipótesis, experimentos, críticas y refinamiento. En última instancia, la computación cuántica sigue siendo una promesa a largo plazo, y este episodio no cambia el hecho de que los ordenadores cuánticos prácticos probablemente lleguen, pero quizás no tan rápido ni de la mano de los qubits topológicos.
Empresas
Europa frena la guerra de chips de EE.UU.: restricciones a ASML
La Unión Europea se opone al MATCH Act que limitaría la venta de litografía DUV a China, defendiendo su autonomía estratégica
TheVortiq

¿Qué ha ocurrido?
El gobierno de Estados Unidos, bajo la administración Biden, ha propuesto el MATCH Act (Monopsony Act Targeting Chinese High-tech), una ley que prohibiría la exportación a China de equipos de litografía de inmersión de aguas profundas (DUV) fabricados por la empresa neerlandesa ASML. Estas máquinas, aunque de generación anterior (de aproximadamente una década), son esenciales para la producción de chips de 28 nm y superiores, utilizados en automoción, electrónica de consumo y aplicaciones industriales. Según declaraciones del CEO de ASML, Christophe Fouquet, a TechCrunch en mayo de 2025, lo que China puede comprar actualmente son herramientas DUV de generación anterior, los mismos equipos que el MATCH Act pondría fuera de los límites.
La Unión Europea, liderada por Países Bajos y Alemania, ha respondido con una declaración conjunta en la que advierte que esta medida unilateral socava la autonomía estratégica europea y amenaza la viabilidad de su industria de semiconductores. Bruselas ha iniciado consultas formales con Washington para buscar una solución negociada, mientras prepara posibles contramedidas, como restricciones a la exportación de tierras raras o equipos de fabricación de chips europeos a Estados Unidos. Este movimiento se produce en un contexto donde la guerra tecnológica entre Estados Unidos y China se intensifica, con antecedentes como las restricciones a Huawei en 2019 y la Ley de Chips de EE. UU. de 2022.
¿Por qué es importante?
Este conflicto marca un punto de inflexión en la guerra tecnológica entre Estados Unidos y China. Hasta ahora, Washington había logrado imponer restricciones a la venta de equipos de litografía EUV (ultravioleta extrema) a China, pero las máquinas DUV representan un mercado mucho mayor y más lucrativo para ASML. En 2025, ASML vendió 42 sistemas DUV a China, generando aproximadamente 3.200 millones de euros, el 15% de sus ingresos totales. Una prohibición total podría costarle a ASML hasta 1.500 millones de euros anuales en ventas perdidas. Además, los equipos DUV son críticos para la fabricación de chips de 28 nm y superiores, usados en automóviles, electrodomésticos y dispositivos IoT, sectores donde China es un actor clave.
El MATCH Act no solo afecta a ASML, sino también a fabricantes de chips europeos como Infineon y STMicroelectronics, que dependen de la cadena de suministro china. Infineon, por ejemplo, obtiene el 25% de sus ingresos de China, y una interrupción podría afectar sus operaciones. La medida también podría acelerar los esfuerzos de China por desarrollar su propia industria de litografía, como el proyecto SMEE (Shanghai Micro Electronics Equipment), que ya ha logrado avances en máquinas DUV de 90 nm, aunque expertos estiman que China aún está a 5-7 años de producir equipos competitivos de 28 nm.
Históricamente, las restricciones a la exportación de tecnología a China han tenido efectos mixtos. Por ejemplo, las sanciones a Huawei en 2019 impulsaron a China a invertir fuertemente en semiconductores, pero también causaron disrupciones en cadenas globales. En este caso, la UE teme que una acción unilateral estadounidense pueda fragmentar aún más el mercado y debilitar la alianza transatlántica.
¿Qué consecuencias tendrá?
- Para ASML: Pérdida de un mercado clave y posible necesidad de reubicar parte de su producción fuera de Europa para eludir las restricciones. Analistas de Bernstein estiman que una prohibición total reduciría las ganancias de ASML en un 10-15% anual. Además, la empresa podría enfrentar tensiones con su fuerza laboral y gobierno neerlandés.
- Para la UE: Refuerzo de la autonomía estratégica, con inversiones en fabricación local de chips (Ley Europea de Chips, que prevé 43.000 millones de euros hasta 2030) y posibles represalias comerciales. La UE podría gravar servicios digitales estadounidenses o restringir exportaciones de equipos de fabricación de chips europeos, como los de ASML o los de la empresa alemana Süss MicroTec.
- Para China: Aceleración del desarrollo tecnológico propio, aunque a un costo mayor y con retrasos de años. China ya ha duplicado su inversión en I+D de semiconductores en 2024, alcanzando 50.000 millones de dólares, pero aún depende de ASML para el 80% de sus equipos de litografía. Proyectos como SMEE podrían ver un impulso, pero la brecha tecnológica sigue siendo amplia.
- Para Estados Unidos: Riesgo de fractura de la alianza tecnológica con Europa, debilitando el frente común contra China. Si la UE toma represalias, podría afectar a empresas estadounidenses como Applied Materials o Lam Research, que también venden equipos a China. Además, la medida podría ser vista como una violación de las reglas de la OMC, generando disputas legales.
¿Qué deben saber los lectores?
Este enfrentamiento no es solo una disputa comercial, sino un choque de visiones sobre cómo gestionar la seguridad nacional y la globalización tecnológica. Europa defiende que las restricciones deben ser multilaterales y proporcionadas, mientras que Estados Unidos prioriza la contención de China a cualquier costo. Los inversores deben seguir de cerca las negociaciones, ya que una escalada podría afectar a toda la cadena de valor de semiconductores, incluyendo a fabricantes de chips como TSMC y Samsung, que dependen de equipos ASML. Para las empresas tecnológicas, diversificar proveedores y aumentar la resiliencia de la cadena de suministro es más urgente que nunca, especialmente en sectores como automoción y electrónica de consumo.
Un dato relevante es que, según TechCrunch, las máquinas DUV que China puede comprar actualmente son las mismas que el MATCH Act prohibiría, pero ya hay contratos firmados que podrían quedar exentos. Sin embargo, la incertidumbre regulatoria ya está afectando las decisiones de inversión. Por ejemplo, SMIC, el mayor fabricante de chips chino, ha retrasado sus planes de expansión de capacidad de 28 nm a la espera de claridad. En resumen, el MATCH Act podría ser un punto de no retorno en la guerra tecnológica, con implicaciones que van más allá de los semiconductores y afectan la geopolítica global.
Empresas
Cisco bajo fuego: SSRF y 0-day en SD-WAN explotados activamente
Dos vulnerabilidades críticas ponen en jaque a Unified Communications Manager y Catalyst SD-WAN, con ataques en curso que exponen redes corporativas enteras.
TheVortiq

¿Qué ha ocurrido?
Dos vulnerabilidades críticas en productos de Cisco están siendo explotadas activamente. La primera, CVE-2026-20230, es un server-side request forgery (SSRF) en Cisco Unified Communications Manager (CUCM). Cisco parchó el fallo a principios de junio y ya existía un proof-of-concept. Ahora, la firma de inteligencia de amenazas Defused ha confirmado que atacantes están utilizando ese exploit para desplegar un servicio Apache Axis malicioso, escribir un JSP de primera etapa y finalmente un shell de ejecución de comandos en /platform-services/axis2-web/. El atacante obtiene privilegios de root en el dispositivo comprometido.
La segunda, CVE-2026-20245, es un 0-day en Cisco Catalyst SD-WAN que permite a un atacante autenticado local ejecutar comandos arbitrarios como root mediante un archivo manipulado. Cisco lo reveló en junio, pero Mandiant descubrió que la explotación comenzó mucho antes, a principios de 2026. En un incidente con un proveedor de servicios de comunicaciones, el atacante obtuvo acceso inicial a través de una conexión de peering no autorizada, abusó de la trama SD-WAN para autenticarse vía SSH, cambió la contraseña de la cuenta admin, exfiltró configuraciones y luego, para no ser detectado, restauró la contraseña original. Para escalar a root, subió un archivo llamado evil_tenant.csv que contenía el payload del exploit, creando una cuenta troot con privilegios completos.
¿Por qué es importante?
Estas vulnerabilidades representan una amenaza grave para infraestructuras críticas. CUCM es el corazón de las comunicaciones unificadas en muchas empresas; un compromiso permite interceptar llamadas, modificar configuraciones y moverse lateralmente. SD-WAN, por su parte, gestiona el tráfico de red de toda una organización. Como señala Mandiant, un atacante con acceso root al controlador SD-WAN tiene visibilidad total del tráfico corporativo, lo que lo convierte en un objetivo prioritario para grupos patrocinados por estados que buscan establecer acceso persistente para espionaje a largo plazo. Cisco ya ha reportado seis vulnerabilidades en SD-WAN bajo ataque desde inicio de año, y este es el segundo 0-day en dos meses.
Consecuencias y contexto
El caso de CVE-2026-20245 es particularmente preocupante porque demuestra que los atacantes están explotando fallos antes de que Cisco los conozca, y que logran mantener el acceso sin ser detectados durante meses. La técnica de cambiar la contraseña y luego restaurarla indica un alto grado de sofisticación y conocimiento de las operaciones de la víctima. Para las empresas, esto significa que los parches no son suficientes; se requiere monitorización activa de comportamientos anómalos en dispositivos de red, especialmente en cuentas administrativas y en el tráfico de gestión.
Además, la cadena de explotación de CVE-2026-20230 muestra cómo los atacantes combinan múltiples técnicas (SSRF, despliegue de servicios maliciosos, escritura de archivos) para lograr una puerta trasera persistente. Las organizaciones que usan CUCM deben verificar que han aplicado el parche de junio y revisar sus registros en busca de actividad sospechosa en los endpoints mencionados.
¿Qué deben saber los lectores?
- Parchear inmediatamente: Cisco ha publicado actualizaciones para ambas vulnerabilidades. Si no se han aplicado, hágalo de urgencia.
- Monitorear indicadores de compromiso: Busque archivos
evil_tenant.csvo similares, cuentas comotroot, y actividad inusual en/platform-services/axis2-web/. - Revisar cuentas administrativas: Cambie contraseñas predeterminadas y audite los accesos SSH y web a dispositivos SD-WAN y CUCM.
- Segmentar redes: Limite el peering no autorizado y restrinja el acceso a la interfaz de gestión solo a direcciones IP confiables.
- Prepararse para más: La tendencia de ataques a SD-WAN continuará. Considere soluciones de detección de intrusiones específicas para este tipo de dispositivos.
“El atacante explotó CVE-2026-20245 para escalar a root y creó una cuenta llamada troot con privilegios completos. Luego restauró la contraseña original para no levantar sospechas”, detalla Mandiant en su informe.
En resumen, estamos ante una situación crítica que requiere acción inmediata. La combinación de un SSRF explotado activamente y un 0-day en SD-WAN con uso anticipado subraya la necesidad de una postura de seguridad proactiva, más allá de la simple aplicación de parches.
Inteligencia Artificial
Claude: ¿compartirá tus datos con la policía sin orden judicial?
La nueva política de privacidad de Anthropic amplía los supuestos para entregar información personal a autoridades, generando alarma entre usuarios y expertos.
TheVortiq

¿Qué ha ocurrido?
El próximo 8 de julio entrará en vigor la nueva política de privacidad de Claude, la inteligencia artificial de Anthropic. La actualización introduce un cambio significativo: la empresa podrá compartir datos personales de los usuarios —incluyendo documentos de identidad como DNI o pasaporte e información biométrica— con autoridades gubernamentales o fuerzas de seguridad sin requerir una orden judicial en determinadas circunstancias.
Según reporta Hipertextual, la política anterior limitaba la entrega de datos a cumplimiento de requisitos legales, como una solicitud judicial. La nueva redacción amplía los supuestos a situaciones como emergencias, violaciones de los términos de uso o investigaciones internas de Anthropic. Esto ha generado una fuerte polémica, especialmente porque Claude exige verificación de identidad con DNI o pasaporte desde principios de año para acceder a ciertas funciones.
La actualización no es un cambio menor: Anthropic, que hasta ahora se había presentado como un bastión de la IA responsable, ahora flexibiliza la protección de datos sensibles. La política de privacidad anterior, vigente desde el lanzamiento de Claude, establecía que solo compartiría información personal en respuesta a "procesos legales válidos" como órdenes judiciales. La nueva redacción, en cambio, incluye una cláusula que permite la divulgación cuando Anthropic "determine de buena fe que es necesario para proteger sus derechos, su propiedad o la seguridad de sus usuarios o del público". Este lenguaje amplio deja espacio para interpretaciones que podrían eludir el control judicial.
¿Por qué es importante?
La recolección de datos biométricos y documentos de identidad por parte de empresas tecnológicas es un tema sensible. La posibilidad de que estos datos sean compartidos con la policía sin control judicial previo sienta un precedente peligroso para la privacidad digital. Además, la falta de transparencia sobre qué constituye una 'emergencia' o una 'violación de términos' deja un amplio margen de interpretación que podría abusarse.
Comparado con otras empresas del sector, como OpenAI o Google, Anthropic se había posicionado como un actor más responsable en materia de IA. Esta política erosiona esa confianza y pone en entredicho su compromiso con la protección de datos. Por ejemplo, OpenAI requiere una orden judicial para compartir datos con autoridades, según su política de privacidad actualizada en 2024. Google, por su parte, publica informes de transparencia sobre solicitudes gubernamentales. Anthropic, en cambio, no ha detallado cómo reportará estas divulgaciones.
El contexto histórico es relevante: desde los casos de Snowden en 2013, la confianza en las empresas tecnológicas para proteger datos frente a gobiernos ha sido frágil. La decisión de Anthropic llega en un momento de creciente escrutinio sobre la IA y la biometría. En la Unión Europea, el Reglamento General de Protección de Datos (GDPR) exige que cualquier transferencia de datos personales a autoridades esté basada en una base legal clara y proporcionada. La nueva política de Anthropic podría violar este principio, ya que las excepciones son vagas y no requieren supervisión judicial.
¿Qué consecuencias tendrá?
Las consecuencias son múltiples: para los usuarios, supone un riesgo de que sus datos íntimos terminen en manos de autoridades sin las garantías legales habituales. Para Anthropic, puede traducirse en una pérdida de credibilidad y en posibles desafíos legales en jurisdicciones con leyes de protección de datos estrictas, como la UE bajo el GDPR. Además, podría incentivar a que otros actores del sector adopten políticas similares, normalizando la entrega de datos sin orden judicial.
Expertos en privacidad advierten que esta política podría vulnerar derechos fundamentales, especialmente si se aplica a usuarios que no han cometido delito alguno, sino que simplemente infringieron términos de servicio. La Electronic Frontier Foundation (EFF) ha señalado en el pasado que las cláusulas de "emergencia" son a menudo utilizadas para justificar vigilancia masiva. En el caso de Anthropic, la falta de definición concreta de "emergencia" podría permitir desde una amenaza de bomba hasta un simple tuit crítico contra el gobierno.
El impacto en el mercado también es significativo. Anthropic compite directamente con OpenAI y Google en el espacio de la IA conversacional. Si los usuarios perciben que Claude es menos seguro, podrían migrar a alternativas como ChatGPT o Gemini. Además, empresas que utilizan Claude para integrar IA en sus productos podrían reconsiderar su dependencia, especialmente aquellas en sectores regulados como salud o finanzas, donde la privacidad de datos es crítica.
Un precedente similar ocurrió en 2018 cuando Facebook compartió datos de usuarios con autoridades en Myanmar para identificar a presuntos incitadores al odio, sin orden judicial, lo que generó críticas globales. Sin embargo, en ese caso, Facebook actuó bajo presión internacional y en un contexto de genocidio. La política de Anthropic, en cambio, es preventiva y aplica a cualquier usuario, lo que la hace más amplia.
¿Qué deben saber los lectores?
Si eres usuario de Claude, debes saber que a partir del 8 de julio tus datos de verificación de identidad (DNI, pasaporte, biometría) podrían ser compartidos con la policía bajo ciertas condiciones que no requieren orden judicial. Aunque Anthropic afirma que no usará estos datos para entrenar modelos ni para marketing, la nueva política amplía los casos en que puede cederlos a terceros.
Se recomienda revisar la política de privacidad actualizada y considerar si se desea continuar usando el servicio. También es importante estar atento a posibles cambios regulatorios o acciones de organismos de protección de datos. En concreto, usuarios en la UE pueden presentar quejas ante sus autoridades de protección de datos si consideran que la política viola el GDPR. Además, organizaciones como la EFF o Privacy International podrían lanzar campañas de presión contra Anthropic.
Para aquellos que decidan seguir usando Claude, es recomendable minimizar la información personal compartida: evitar subir documentos sensibles y no utilizar la verificación de identidad a menos que sea estrictamente necesario. Asimismo, se puede optar por usar Claude sin crear una cuenta, aunque las funcionalidades serán limitadas.
En resumen, la nueva política de privacidad de Claude representa un giro preocupante en la postura de Anthropic sobre la privacidad. Mientras la empresa argumenta que busca cumplir con la ley y proteger a los usuarios, los críticos ven una puerta abierta a la vigilancia sin control. El tiempo dirá si esta decisión afecta su reputación y su posición en el mercado, pero por ahora, los usuarios deben estar alerta.
Inteligencia Artificial
IBM presenta chip con 100 mil millones de transistores: la Ley de Moore se extiende una década más
El nuevo diseño de apilamiento vertical de transistores promete duplicar la densidad, mejorar el rendimiento hasta un 50% y la eficiencia energética hasta un 70%.
TheVortiq
¿Qué ha ocurrido?
IBM ha anunciado un prototipo de chip que integra unos 100 mil millones de transistores en un área similar a una uña, duplicando la densidad de su tecnología anterior de 2021. Para lograrlo, la compañía ha adoptado una arquitectura denominada nanostack, que apila verticalmente los transistores en dos capas, en lugar de reducirlos horizontalmente. Este diseño, conocido como CFET (Complementary Field-Effect Transistor), permite que los chips realicen hasta un 50% más de trabajo en el mismo tiempo y sean hasta un 70% más eficientes energéticamente, según IBM. El anuncio se realizó durante una conferencia de prensa el martes, donde Jay Gambetta, director de IBM Research, calificó el avance como "un salto significativo" y no solo un paso incremental. Dan Hutcheson, vicepresidente de TechInsights, afirmó que esta innovación "pone otros diez o quince años en la hoja de ruta".
¿Por qué es importante?
La Ley de Moore, que predice que el número de transistores en un chip se duplica cada dos años, ha sido el motor del progreso tecnológico durante más de medio siglo. Sin embargo, en los últimos quince años los transistores han alcanzado escalas de unos pocos nanómetros, donde los efectos cuánticos interfieren con su funcionamiento. El apilamiento vertical ofrece una vía para seguir aumentando la densidad sin reducir el tamaño de los transistores. Históricamente, la industria ha enfrentado desafíos similares: en la década de 2000, el cambio de materiales (como la introducción de high-k dielectrics) permitió continuar la miniaturización. Ahora, el apilamiento vertical representa un cambio de paradigma comparable. El impacto potencial es enorme: desde centros de datos más eficientes hasta procesadores más potentes para inteligencia artificial y dispositivos móviles. IBM espera que los chips con nanostack se generalicen en centros de datos dentro de una década, ayudando a gestionar mejor el consumo energético. Según datos de la Agencia Internacional de la Energía, los centros de datos consumen aproximadamente el 1% de la electricidad global, y su demanda crece rápidamente con la expansión de la IA. Una mejora del 70% en eficiencia energética podría reducir significativamente este consumo.
¿Cómo funciona?
El proceso de fabricación se realiza capa por capa. Primero se construyen transistores en una capa de silicio; luego se deposita otra capa de silicio encima y se fabrican transistores en ella; finalmente se conectan eléctricamente ambas capas. A diferencia de otros enfoques como el 3D V-Cache de AMD o el LogicFolding de Huawei, que fabrican las capas por separado y luego las unen (técnica conocida como bonding), IBM crea los transistores directamente sobre la capa inferior, lo que permite un alineamiento más preciso y una mayor densidad. Además, los transistores de la segunda capa no se sitúan exactamente encima de los de la primera, sino que están escalonados, simplificando el cableado y reduciendo la resistencia eléctrica. Este diseño escalonado es una innovación clave que distingue a IBM de sus competidores. Según Huiming Bu, vicepresidente de I+D global de semiconductores de IBM, "el apilamiento monolítico permite una integración más estrecha y un mejor rendimiento". La arquitectura CFET combina transistores de tipo N y P en la misma estructura vertical, optimizando el espacio y el consumo de energía.
¿Qué consecuencias tendrá?
A corto plazo, IBM colaborará con fabricantes de semiconductores para llevar la tecnología a la producción. Se espera que diseñadores de chips adopten esta arquitectura para CPUs, GPUs y otros procesadores. A largo plazo, la técnica podría extender la vida de la Ley de Moore y mantener el ritmo de innovación en computación. Sin embargo, no es la única empresa en esta carrera: Intel, Samsung y TSMC también investigan CFETs. Intel ha presentado su propia visión de transistores apilados (llamada RibbonFET), mientras que TSMC ha demostrado prototipos de CFET. La propuesta de IBM se distingue por su diseño escalonado y su enfoque monolítico, que podría ofrecer ventajas en coste y rendimiento. No obstante, el camino hacia la comercialización es largo: los prototipos de IBM suelen tardar años en llegar al mercado. Por ejemplo, su tecnología de 7 nm se anunció en 2015 pero no se integró en productos hasta 2018. Además, la fabricación de chips apilados requiere equipos litográficos avanzados (como EUV) y procesos de deposición de capas precisos, lo que aumenta los costes de producción. Para los usuarios finales, esto podría traducirse en ordenadores más rápidos y eficientes, pero no de inmediato. En el ámbito empresarial, los centros de datos podrían beneficiarse primero, reduciendo sus facturas energéticas y su huella de carbono.
¿Qué deben saber los lectores?
- El chip es un prototipo; los productos comerciales podrían tardar años en llegar. IBM ha sido pionera en investigación, pero la producción en masa depende de socios como Samsung o GlobalFoundries.
- La eficiencia energética es clave: hasta un 70% menos consumo para la misma carga de trabajo, lo que podría revolucionar la sostenibilidad de los centros de datos.
- La tecnología se aplicará primero en centros de datos, pero podría llegar a dispositivos de consumo como smartphones y laptops en la próxima década.
- La Ley de Moore no ha muerto, pero ha cambiado de dirección: ahora se construye hacia arriba, no hacia abajo. Este cambio es comparable al salto de los transistores planos a los FinFET en la década de 2010.
- La competencia es feroz: Intel, TSMC y Samsung también avanzan en apilamiento vertical, por lo que IBM no es la única opción. La ventaja de IBM radica en su diseño escalonado y su enfoque monolítico.
"No es solo un paso incremental, es un salto significativo", afirmó Jay Gambetta, director de IBM Research.
En resumen, el anuncio de IBM marca un hito en la evolución de los semiconductores, ofreciendo un camino viable para continuar la Ley de Moore más allá de los límites físicos de la miniaturización. Sin embargo, la adopción generalizada requerirá superar desafíos de fabricación y costos, y la competencia con otros gigantes tecnológicos mantendrá la presión innovadora. Los próximos años serán cruciales para ver si esta tecnología se convierte en el estándar de la próxima década.
Empresas
Ciberataque a Klue: datos robados de cientos de clientes, incluyendo empresas de seguridad
Un grupo llamado Icarus explota credenciales legacy para robar datos de Salesforce a través de la integración de Klue, afectando a firmas como Huntress, Recorded Future y Tanium.
TheVortiq

¿Qué ha ocurrido?
El 11 de junio de 2026, Klue, plataforma de inteligencia de mercado utilizada por más de 250.000 empresas, sufrió una brecha de seguridad. Un atacante accedió a través de una credencial legacy comprometida asociada a un servicio de integración, obteniendo tokens OAuth que permitían conectar Klue con plataformas de terceros como Salesforce, Gong, HubSpot, SharePoint y Google Drive. Con esos tokens, el atacante accedió a datos dentro de los entornos conectados de numerosos clientes. Según The Register, Klue no ha especificado cuántos clientes se vieron afectados, pero Huntress confirmó que estaba entre los "cientos de clientes de Klue" impactados.
Klue detectó la intrusión al día siguiente, desconectó todas las integraciones y contrató a CrowdStrike para investigar. El CEO Jason Smith confirmó el incidente en un blog. El grupo responsable se hace llamar Icarus, activo desde el 28 de abril de 2026, y comenzó a publicar víctimas en su sitio de filtración de datos. Icarus exige comunicación a través de Session para evitar la filtración pública, una táctica similar a la de grupos como ShinyHunters, pero con un enfoque en la extorsión directa.
¿Por qué es importante?
El ataque no solo afectó a empresas comunes, sino a firmas de ciberseguridad como Huntress, Recorded Future, Tanium, Jamf, Gong, HackerOne, Kudelski Security, Snyk, Insurity y Sprout Social. Esto demuestra que incluso los guardianes de la seguridad pueden ser víctimas de ataques a la cadena de suministro. Huntress, que fue de las primeras en alertar, confirmó que los datos robados incluían contactos comerciales, cotizaciones y mensajes de ventas, pero no información altamente sensible como contraseñas o datos de ingeniería. En un comunicado, Huntress destacó su compromiso con la transparencia radical: "Los datos copiados de nuestra cuenta de Salesforce incluyen contactos comerciales, cotizaciones de precios y otros datos relacionados con ventas y mensajería. No hay datos de amenazas, contraseñas, información de tarjetas de pago ni datos de ingeniería".
El incidente se asemeja a las campañas de abuso de OAuth de terceros contra Salesforce ocurridas en 2025 y 2026, pero esta vez el actor es Icarus, no ShinyHunters. La brecha subraya el riesgo de las credenciales legacy y la necesidad de rotar tokens OAuth periódicamente. A diferencia de ataques anteriores, este se originó por una credencial legacy asociada a un servicio de integración, no por un fallo en el producto principal de Klue. Esto refleja una tendencia creciente: los atacantes apuntan a integraciones de terceros como vector de entrada, ya que a menudo tienen menos supervisión de seguridad.
Consecuencias y lecciones
Klue ha desconectado todas sus integraciones y está colaborando con CrowdStrike. Mandiant recomienda auditar sistemas y monitorear logs, así como rotar credenciales. Las empresas afectadas deben revisar si el ataque tuvo un impacto mayor, aunque hasta ahora no se ha reportado compromiso de productos o infraestructura propia. Sin embargo, la filtración de datos de CRM puede tener consecuencias comerciales significativas, como la exposición de estrategias de ventas, listas de clientes potenciales y acuerdos en curso. Para empresas de ciberseguridad, esto también puede dañar la confianza de sus propios clientes.
Para los lectores, la lección es clara: las integraciones de terceros son vectores de ataque críticos. Es fundamental gestionar credenciales, usar autenticación multifactor y tener planes de respuesta a incidentes. Además, la transparencia de Huntress y otras empresas sienta un precedente positivo. Como señaló Huntress, la divulgación proactiva ayuda a otras organizaciones a protegerse. El ataque también resalta la importancia de rotar tokens OAuth periódicamente y revocar credenciales legacy que ya no son necesarias.
¿Qué deben saber los lectores?
- El ataque se originó por una credencial legacy comprometida asociada a un servicio de integración.
- Los datos robados son principalmente de CRM (contactos, cotizaciones, mensajes de ventas).
- No se han visto afectados productos o sistemas críticos de las víctimas, según las empresas afectadas.
- Icarus exige comunicación vía Session para evitar la filtración pública, y ha publicado algunas víctimas en su sitio.
- Se recomienda auditar integraciones, rotar tokens OAuth y revisar el uso de credenciales legacy.
- Empresas como Huntress, Recorded Future, Tanium, Jamf, Gong, HackerOne, Kudelski Security, Snyk, Insurity y Sprout Social están entre las víctimas confirmadas.
Este incidente es un recordatorio de que la seguridad de la cadena de suministro es tan fuerte como su eslabón más débil. Las empresas deben evaluar no solo la seguridad de sus propios sistemas, sino también la de los proveedores con los que se integran. La rotación periódica de tokens y la eliminación de credenciales obsoletas son medidas simples pero efectivas. Además, la respuesta coordinada de Klue y CrowdStrike, junto con la transparencia de las víctimas, puede servir como modelo para futuros incidentes.
Inteligencia Artificial
Anthropic acusa a Alibaba de robar datos de Claude con 25.000 cuentas falsas
La mayor campaña de destilación de IA conocida revela los riesgos de la extracción de modelos y la tensión tecnológica entre EE.UU. y China
TheVortiq

¿Qué ha ocurrido?
Anthropic, la empresa estadounidense responsable del modelo de inteligencia artificial Claude, ha acusado a Alibaba de llevar a cabo un ataque masivo de extracción de datos utilizando aproximadamente 25.000 cuentas falsas. Según una carta enviada al Comité Bancario del Senado de EE.UU. el 10 de junio, la campaña se desarrolló entre el 22 de abril y el 5 de junio de 2026, generando más de 28,8 millones de intercambios con Claude. La técnica empleada, conocida como "destilación", permite entrenar un modelo menos potente a partir de las respuestas de uno más avanzado, lo que podría permitir a Alibaba replicar las capacidades de Claude a un costo reducido. Anthropic atribuye la operación a operadores afiliados a Alibaba y a su laboratorio de IA, Alibaba Qwen.
¿Por qué es importante?
Este incidente representa el mayor ataque de destilación conocido contra Anthropic hasta la fecha. No es un caso aislado: en febrero de 2026, la empresa ya había identificado campañas similares por parte de DeepSeek, Moonshot AI y MiniMax, con volúmenes de intercambios que oscilaban entre 150.000 y más de 13 millones. La repetición de estos eventos sugiere que la extracción de modelos se está convirtiendo en una práctica sistemática, lo que plantea serios riesgos para la propiedad intelectual y la ventaja competitiva de las empresas de IA. Además, el contexto geopolítico es clave: Anthropic señala que la campaña podría acelerar la capacidad de China para alcanzar el nivel de modelos avanzados como Claude, mientras que las autoridades estadounidenses han incrementado la vigilancia sobre la IA avanzada debido a preocupaciones de seguridad nacional.
Consecuencias para el sector
La destilación de modelos representa un nuevo riesgo en la cadena de suministro empresarial. Como señala Sanchit Vir Gogia, analista jefe de Greyhound Research, "la cadena de suministro empresarial ya no termina en software, API y regiones cloud; ahora incluye inteligencia alquilada, y la inteligencia alquilada puede copiarse y reimplementarse fuera de los controles de seguridad con los que nació". Esto implica que las empresas que utilizan modelos de IA a través de API podrían estar expuestas a que sus datos sean utilizados para entrenar modelos competidores sin su consentimiento. Además, la destilación permite que un modelo más débil herede las capacidades de uno más fuerte sin las mismas salvaguardas, lo que podría derivar en usos no deseados o en la proliferación de sistemas de IA menos controlados.
¿Qué deben saber los lectores?
Para las empresas que integran IA en sus operaciones, este caso subraya la importancia de verificar las políticas de uso de los proveedores de modelos y de implementar medidas de detección de anomalías. Los equipos de seguridad deben estar atentos a picos inusuales de tráfico desde ciertas direcciones IP o patrones de consulta que puedan indicar intentos de destilación. Asimismo, es crucial que las empresas de IA fortalezcan sus sistemas de monitoreo y colaboren con las autoridades para identificar y bloquear este tipo de actividades. A nivel regulatorio, el incidente podría impulsar una mayor cooperación internacional y el desarrollo de marcos legales específicos para la protección de modelos de IA.
Contexto histórico y comparaciones
La destilación de modelos no es un fenómeno nuevo, pero su escala ha crecido exponencialmente. En 2023, se reportaron casos de extracción de datos de GPT-3.5, pero con volúmenes mucho menores. La diferencia ahora radica en la sofisticación de los ataques y la capacidad de generar millones de consultas de forma automatizada. Este caso también se asemeja a los conflictos previos por scraping de datos, como el caso de Meta contra Bright Data, pero la destilación de IA añade una capa adicional de complejidad al permitir la transferencia de capacidades, no solo de datos.
"La inteligencia alquilada puede copiarse y reimplementarse bien fuera de los controles de seguridad con los que nació." – Sanchit Vir Gogia, analista jefe de Greyhound Research
Implicaciones geopolíticas
La acusación de Anthropic se produce en un momento de creciente tensión tecnológica entre Estados Unidos y China. El gobierno estadounidense ha impuesto restricciones a la exportación de chips avanzados y ha aumentado el escrutinio sobre los modelos de IA que podrían ser utilizados por militares o servicios de inteligencia de países considerados adversarios. Si se confirma que Alibaba ha estado extrayendo capacidades de Claude, esto podría endurecer aún más las políticas de control de acceso a modelos de IA y fomentar una fragmentación del ecosistema global de IA.
Recomendaciones para empresas
- Revisar los términos de servicio de los proveedores de IA y asegurarse de que prohíben explícitamente la destilación.
- Implementar sistemas de detección de patrones anómalos en el uso de APIs de IA.
- Establecer alertas para volúmenes de consultas inusualmente altos desde orígenes específicos.
- Participar en iniciativas sectoriales para compartir información sobre amenazas de extracción de modelos.
El futuro de la destilación
Es probable que veamos un aumento en los esfuerzos de destilación a medida que más actores busquen acceder a modelos de vanguardia sin invertir en su desarrollo. Las empresas de IA deberán innovar en técnicas de protección, como la inyección de ruido en las respuestas, la limitación de consultas por cuenta o el uso de marcas de agua en los datos generados. La colaboración entre empresas y reguladores será esencial para establecer estándares que disuadan estas prácticas sin obstaculizar la innovación.